Si yo mezclo perfiles mal, puedo romper consentimientos, pedidos y soporte. Si no uno duplicados, trabajo con historiales partidos. La salida no es “fusionar todo”: es comparar mejor, revisar con una frecuencia fija y dejar cada decisión registrada.
En simple, yo me quedo con esta idea:
Hay un dato que me parece clave: cuando una marca suma tienda, CRM, WhatsApp, Instagram, soporte y pagos, la chance de duplicados sube mucho. Esto es común al integrar una plataforma de WhatsApp para TiendaNube con otros canales. Y en picos como Hot Sale o CyberMonday, el riesgo crece todavía más. Por eso, no alcanza con una limpieza cada tanto.
Si yo tuviera que resumir el criterio de trabajo en una sola lista, sería esta:
merge_id, fecha, regla aplicada, puntaje y responsable.| Tema | Regla corta |
|---|
| Duplicado | Dos o más registros apuntan a la misma persona |
| Vinculación | Los perfiles siguen separados, pero conectados |
| Campo más confiable | ID verificado |
| Campos útiles | Email, teléfono, nombre, domicilio, IDs transaccionales |
| Riesgo común | Unir personas distintas por compartir dirección o teléfono |
| Manda el estado más restrictivo | |
| Pedidos y reembolsos | Se conservan con su ID y estado original |
| Auditoría | Cada decisión queda registrada y reversible |
Yo leería el resto del artículo con una pregunta en mente: ¿mis reglas están evitando duplicados sin mezclar personas que no corresponden? Ahí está el punto.
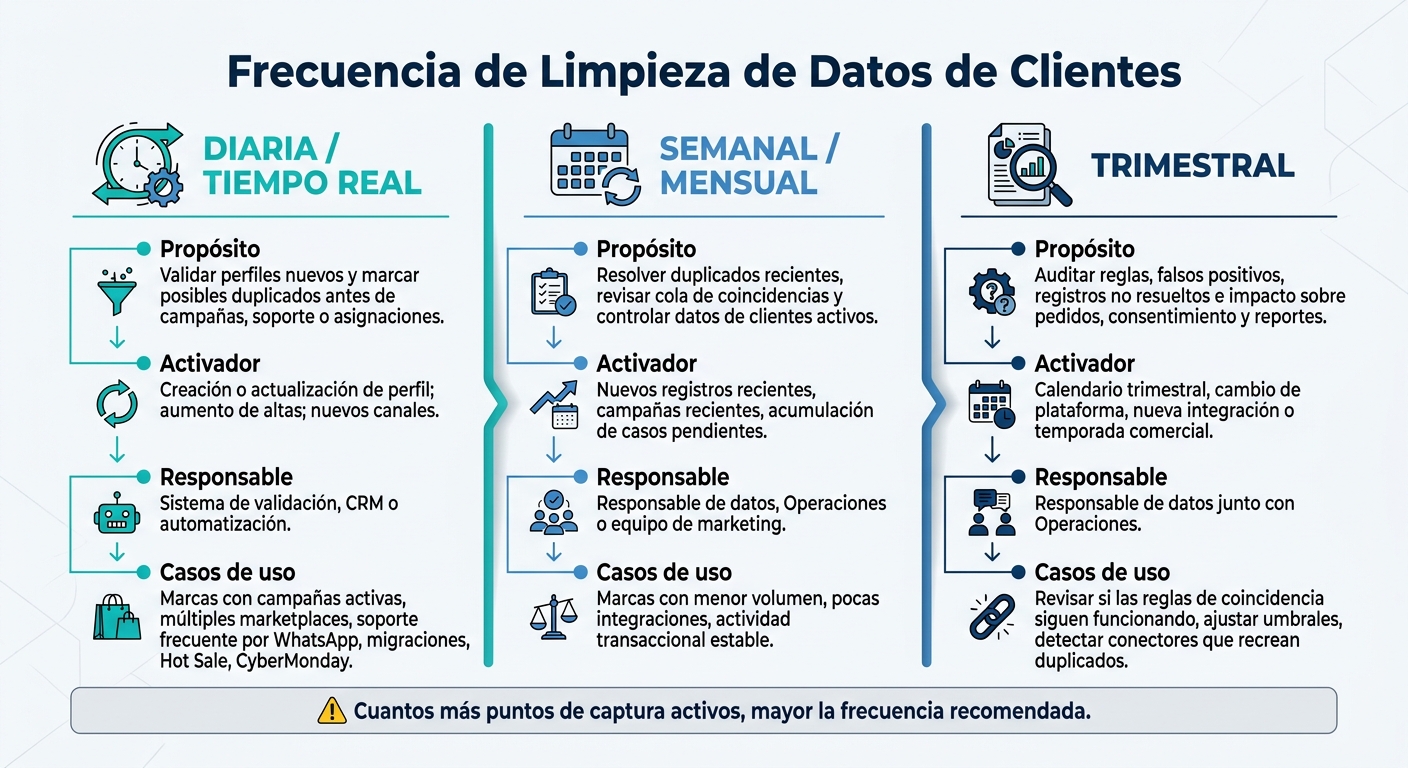
Frecuencia de Limpieza de Datos de Clientes: Guía Visual
No hay una sola respuesta. La frecuencia correcta depende de cuatro variables: el volumen de altas diarias o semanales, la cantidad de canales de adquisición activos, la frecuencia de compras y el riesgo de operar con duplicados activos. Cuantos más puntos de captura tengas, más chances de que aparezcan duplicados.
La práctica más usada mezcla tres capas: validación diaria o en tiempo real, revisiones semanales o mensuales y una auditoría trimestral.
| Frecuencia | Propósito | Activador | Responsable |
|---|---|---|---|
| Diaria o en tiempo real | Validar perfiles nuevos y marcar posibles duplicados antes de que entren en campañas, soporte o asignaciones | Creación o actualización de un perfil; aumento de altas; nuevos canales | Sistema de validación, CRM o automatización |
| Semanal o mensual | Resolver duplicados recientes, revisar la cola de coincidencias y controlar datos de clientes activos | Nuevos registros recientes, campañas recientes o acumulación de casos pendientes | Responsable de datos, Operaciones o equipo de marketing |
| Trimestral | Auditar reglas, falsos positivos, registros no resueltos y el impacto sobre pedidos, consentimiento y reportes | Calendario trimestral, cambio de plataforma, nueva integración o temporada comercial | Responsable de datos junto con Operaciones |
Con esta cadencia definida, el siguiente paso es decidir qué campos usar para detectar duplicados.
El control diario hace falta cuando los perfiles se crean o se actualizan rápido y desde muchos lugares al mismo tiempo. Una marca de indumentaria con campañas de adquisición activas todos los días, un vendedor en varios marketplaces o una tienda con soporte frecuente por WhatsApp en TiendaNube son buenos ejemplos. En esos casos, esperar una semana para revisar duplicados ya es tarde.
La meta es simple: frenar el duplicado antes de que entre en campañas, soporte o asignaciones. También conviene activar este nivel de control durante migraciones, lanzamientos de nuevas integraciones y picos estacionales como Hot Sale o CyberMonday. Es ahí donde pasan a jugar las reglas de normalización y coincidencia.
Las marcas con menor volumen, pocas integraciones y una actividad transaccional estable pueden funcionar bien con revisiones semanales o mensuales, siempre que exista validación automática en el punto de captura. La revisión semanal sirve para cubrir los perfiles creados hace poco. La mensual suma una mirada sobre la tasa de duplicados, los campos incompletos y los casos pendientes sin resolver.
La auditoría trimestral, en cambio, no debería quedarse solo en fusionar registros. Tiene que revisar si las reglas de coincidencia siguen funcionando, si hay falsos positivos, si algún conector está recreando duplicados y si pedidos, devoluciones o consentimientos quedaron afectados. Cada trimestre, compará indicadores y ajustá los umbrales si cambió el comportamiento del negocio.
El nombre, por sí solo, no alcanza. Para detectar duplicados sin mezclar personas distintas, conviene combinar varios campos que cumplen funciones diferentes. La forma más clara es separarlos en tres grupos.
Los identificadores fuertes incluyen el ID de cliente verificado y, cuando exista, un ID de fidelización o de cuenta autenticada. También entran el email y el teléfono normalizados. Son señales fuertes, sí, pero no infalibles: puede haber casillas compartidas, números usados por la familia o datos viejos. En cambio, si el ID de cliente está verificado, la coincidencia es concluyente. Por eso, los identificadores fuertes sirven para evitar fusiones erróneas, mientras que los campos de apoyo ayudan a confirmar casos dudosos.
Los campos de apoyo - como nombre completo, dirección estructurada, código postal, localidad y provincia - permiten reforzar o poner en duda lo que muestran los identificadores fuertes. Y los identificadores transaccionales, como el ID de pedido, la referencia de pago o el ID de suscripción, ayudan a conectar actividad comercial. Ojo: un pedido puede incluir datos de entrega de otra persona.
| Grupo | Ejemplos | Uso |
|---|---|---|
| Identificadores fuertes | ID de cliente, email normalizado y verificado, teléfono normalizado, ID de fidelización | Exacto luego de normalizar; concluyente si el ID está verificado |
| Campos de apoyo | Nombre completo, dirección estructurada, localidad, código postal, provincia, fecha de nacimiento | Similitud + combinación de campos |
| Identificadores transaccionales | ID de pedido, referencia de pago, ID de suscripción | Exacto para vincular actividad |
Una vez que definiste los campos, el siguiente paso es normalizarlos antes de comparar. Si no hacés eso, terminás comparando versiones distintas del mismo dato y se te escapan coincidencias.
Para el email, pasalo a minúsculas, quitá espacios al principio y al final, y validá que tenga @. Ana.Perez@Ejemplo.com debería compararse como ana.perez@ejemplo.com. No elimines etiquetas como +web sin revisar antes cómo las maneja el proveedor de correo.
Para el teléfono, guardá una versión canónica con el código de país +54, el código de área y el número, sacando espacios, guiones y paréntesis. En Argentina, el formato nacional tiene 10 dígitos: código de área y número. También es común ver números con 0 antes del área o con 15 antes del número de celular en la marcación local. Esas variantes hay que estandarizarlas antes de comparar.
Con el nombre, eliminá espacios de más, unificá mayúsculas y tratá los acentos de forma consistente. Así, José María Pérez y jose maria perez pueden tomarse como equivalentes. Conviene guardar nombre y apellido por separado, pero sin perder la ortografía original.
En el domicilio, lo mejor es separar cada parte: calle, altura, piso, departamento, localidad, provincia, código postal y país. Ese detalle evita confundir direcciones parecidas que no son la misma. Si comparás toda la dirección como un solo bloque de texto, aumentan los falsos negativos.
El enfoque que mejor funciona suele tener dos etapas. Primero va la coincidencia exacta, sobre campos confiables que ya fueron normalizados: el mismo ID de cliente verificado, el mismo email verificado o el mismo teléfono verificado. Si aparece una coincidencia en uno de esos campos, el caso avanza con un nivel alto de confianza.
Después entran las reglas de similitud, pero solo como apoyo. Ahí se revisan nombres y domicilios para encontrar errores de tipeo, abreviaturas, caracteres transpuestos o cambios de formato. Una regla difusa no debería dispararse sola. Tiene que venir acompañada por al menos una condición exacta o muy confiable. Por ejemplo: nombre parecido, mismo código postal y el mismo sufijo de teléfono. En cambio, los casos que se contradicen - como mismo nombre con emails distintos, o misma dirección con teléfonos distintos - conviene mandarlos a revisión manual.
Detectar un duplicado es solo la mitad del trabajo: la fusión tiene que conservar consentimientos, compras y devoluciones sin tocar el historial.
El punto más delicado no es solo unir registros. Es mantener permisos y evidencia sin cambios.
El consentimiento de WhatsApp pertenece al canal, al número y a la finalidad. No se traslada desde email, SMS ni cuenta web.
Cuando se fusionan dos perfiles, siempre manda la regla más restrictiva. Si uno de los registros tiene un opt-out, el perfil resultante debe tratarse como opt-out, aunque el otro aparezca como opt-in. Un opt-out nunca puede quedar pisado por un opt-in más antiguo.
Guardá canal, número, finalidad, estado, origen, fecha y hora, y evidencia del consentimiento. Si no podés asociar el número con confianza a la persona, el estado debe quedar como desconocido y hay que bloquear el envío de mensajes proactivos hasta resolverlo.
En marcas que operan ventas y soporte por WhatsApp, Burbuxa puede sincronizar clientes, pedidos y conversaciones; la regla de consentimiento sigue siendo responsabilidad del negocio.
Con el consentimiento resuelto, el siguiente riesgo es no romper la operación comercial.
Una fusión de identidad consolida quién es el cliente. Cada pedido, pago, envío, devolución, cambio, reembolso, contracargo, suscripción, descuento y caso de soporte debe seguir intacto en el sistema de origen, con su ID original, fecha, monto y estado. No borres transacciones para deduplicar: rompés contabilidad, reclamos y trazabilidad.
Lo que sí cambia es la referencia. Los registros históricos quedan vinculados al perfil consolidado, pero sin tocar ningún dato financiero ni operativo. Si una devolución estaba pendiente antes de la fusión, tiene que seguir visible como pendiente. Un reembolso de $ 48.500,00 acreditado al método de pago original conserva su ID y estado, aunque el pedido ahora figure bajo el perfil consolidado.
Con los datos de fidelización, suscripciones y cupones, las reglas de supervivencia deben quedar definidas antes de ejecutar la fusión. Se conserva el historial y el saldo se recalcula una sola vez. Los cupones de un solo uso no se restauran porque dos perfiles se hayan fusionado. Si las reglas no dejan claro el resultado, lo más prudente es pausar la fusión y mandarla a revisión manual.
| Operación | Qué cambia | Qué no cambia |
|---|---|---|
| Fusión de identidad | Los IDs duplicados se consolidan; se aplican reglas de supervivencia a los campos del perfil | IDs originales, historial de consentimientos, marcas de tiempo y evidencia de auditoría |
| Consolidación de pedidos | El historial de compras y casos queda visible desde el perfil consolidado | IDs de pedidos, pagos, envíos, devoluciones, reembolsos, descuentos y estados |
| Fidelización y cupones | El saldo se recalcula una sola vez con el historial unificado | Los registros originales no se tocan; solo cambia su vínculo con el perfil consolidado |
La siguiente decisión es qué reglas aplicar primero para que cada fusión quede auditable.
Antes de automatizar fusiones, definí reglas mínimas de supervivencia y un registro de auditoría.
Una fusión sin rastro de auditoría te deja en una posición incómoda: cuesta explicar por qué se unieron dos perfiles o por qué un cliente dejó de recibir mensajes.
Por eso, cada fusión - automática o manual - tiene que dejar un registro inmutable. Ese registro debe incluir los IDs originales, el ID del perfil que sobrevive, el sistema de origen, la versión de la regla aplicada - por ejemplo, DEDUP-2026.09-v3 - , los campos que coincidieron, el puntaje de confianza, el resultado y quién o qué ejecutó la acción. Puede haber sido un usuario, un proceso automático o un agente de IA. Lo importante es que quede identificado. El timestamp tiene que guardarse en formato local, por ejemplo 29/09/2026 14:30, y también conservar internamente su equivalente en UTC para conciliación.
La trazabilidad también tiene que bajar al nivel de campo. Para cada atributo del perfil consolidado, el log debe mostrar de qué perfil salió el valor, por qué se eligió y cuándo se verificó por última vez. También conviene guardar los valores que quedaron afuera. Ese detalle evita dudas y permite explicar el origen de cada dato sin vueltas.
Y no alcanza con registrar solo las fusiones que sí avanzaron. El log también tiene que cubrir las decisiones que terminaron en rechazo, revisión manual o perfiles vinculados pero separados. Esos casos necesitan su propio registro, junto con las señales en conflicto y la regla de excepción que frenó la fusión. Además, una tabla de referencias cruzadas debe mapear cada ID retirado al ID sobreviviente, para que pedidos, devoluciones, actividad de fidelización e interacciones de soporte sigan siendo buscables. Cada fusión, además, tiene que poder deshacerse con el merge_id, restaurando las relaciones previas sin borrar el registro de auditoría.
Antes de subir el nivel de automatización, hay seis controles que tienen que estar funcionando:
El acceso al log también necesita control. Hablamos de permisos por rol, cifrado, retención definida y protección contra cambios o borrado. Y hay algo más: después de cada ajuste en las reglas, conviene medir falsos positivos, fusiones revertidas y casos enviados a revisión. Si esos números empeoran, el sistema no está aprendiendo: está metiendo más ruido.