Los webhooks avisan de los cambios; el polling consulta si hubo cambios. Ninguno confirma por sí solo que se hayan aplicado. Para monitorear una integración, conviene seguir cada cambio hasta el destino y comprobar que el stock, la orden o el envío quedó actualizado.
Los webhooks reducen la demora. El polling permite revisar diferencias y recuperar datos que la API todavía conserva. Por ejemplo, consultar cada 5 minutos implica una espera promedio de 2,5 minutos, si los cambios se distribuyen uniformemente, más el tiempo de procesamiento.
Comparación rápida
| Criterio | Webhooks | Polling |
|---|---|---|
| Detección | El origen envía una notificación. | La integración consulta a intervalos. |
| Demora | Depende de la entrega y el procesamiento. | Depende del intervalo y la duración del ciclo. |
| Costo y uso de API | Evita consultas vacías; requiere recepción y colas. | Consume consultas incluso sin cambios. |
| Cobertura | Depende de los eventos disponibles. | Depende de los datos y el historial que exponga la API. |
| Control y recuperación | IDs de evento, reintentos y reenvíos. | Ventanas, páginas y checkpoints guardados. |
En ambos casos hacen falta controles contra duplicados y cambios fuera de orden, trazas y alertas sobre datos pendientes. Combinar webhooks con polling ayuda a detectar faltantes, pero la prueba final es verificar el dato aplicado, no contar respuestas HTTP exitosas.
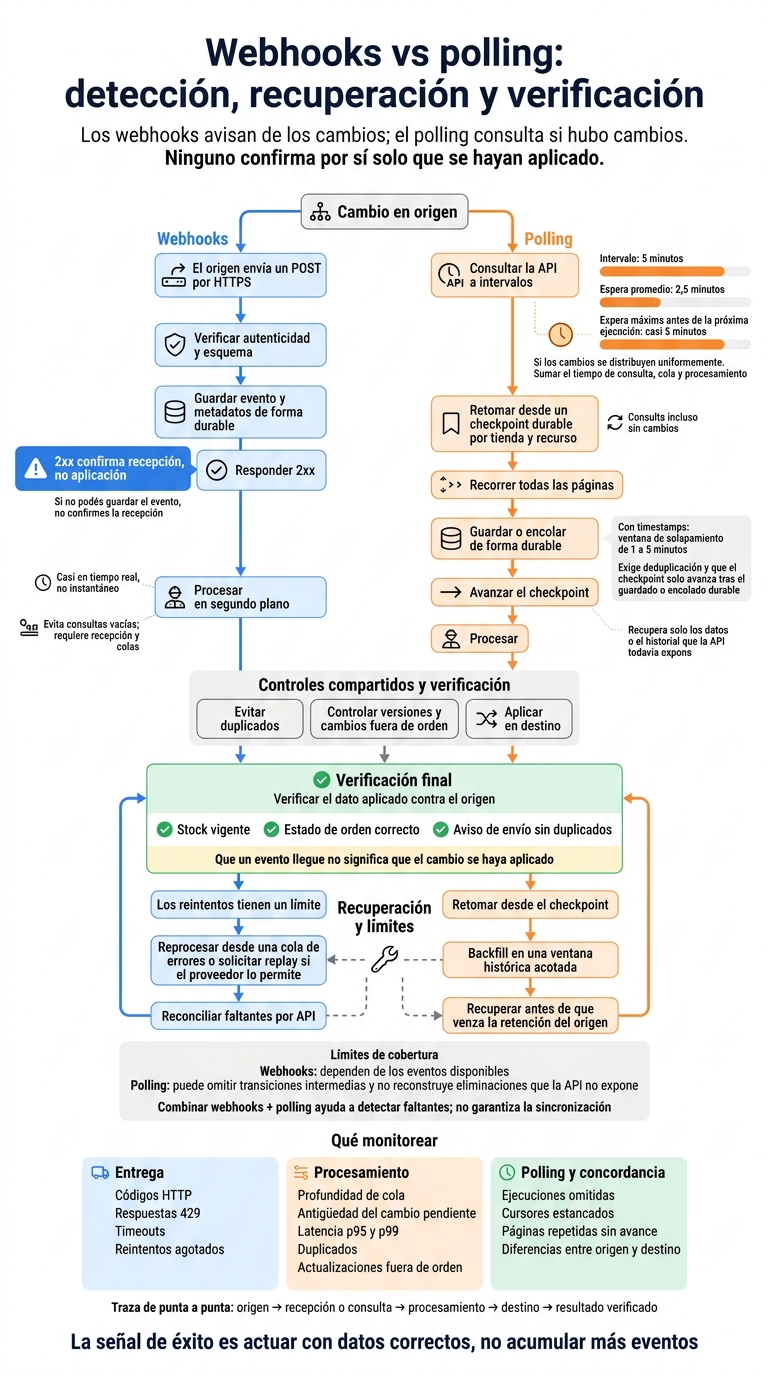
Webhooks vs polling: detección, recuperación y verificación
Entender esta diferencia es clave para depurar problemas de integración API de forma efectiva.
El sistema de origen envía un POST por HTTPS cuando ocurre un cambio al que te suscribiste: el precio de un producto, un ajuste de inventario, la creación o el pago de una orden, o el estado de un envío. La entrega es casi en tiempo real, no instantánea. Entre el evento y su aplicación hay colas, tráfico de red y procesamiento. Registrá cada momento por separado para detectar dónde está la demora. El primer control, entonces, no es la sincronización: es verificar el origen del evento y guardarlo.
Usá un endpoint HTTPS y verificá cada solicitud con el método del proveedor. Si usa HMAC, calculalo sobre el cuerpo original, sin reconstruir el JSON. Controlá también el timestamp, si está disponible. Luego validá el esquema y guardá el evento con sus metadatos antes de responder 2xx. Dejá las tareas de ERP y catálogo para workers en segundo plano. Si no podés guardar el evento, no confirmes la recepción.
Una vez aceptado, evitá los duplicados y las sobrescrituras. Guardá un ID estable del evento con una restricción única y hacé que las acciones posteriores sean idempotentes: repetir el evento no debe repetir sus efectos. Un ID de reenvío no alcanza. Antes de aplicar cambios, compará la versión, la secuencia o el campo updated_at. Si el mensaje no indica el orden, consultá el estado actual en origen.
Con la recepción validada, toca detectar cuándo las entregas dejan de reflejar el estado real.
Monitoreá el estado de entrega, los códigos HTTP, los reintentos agotados, la profundidad de la cola, la antigüedad del evento más viejo y los errores de los handlers de eventos. Registrá también los tipos de evento sin soporte y configurá alertas para ellos.
Documentá la política del proveedor: los reintentos tienen un límite, y una caída puede durar más que esa ventana. Para recuperar eventos, reprocesalos desde una cola de errores o solicitá un replay si el proveedor lo permite. Si faltan eventos, reconciliá el estado con la API de origen mediante filtros por actualización y cursores guardados.
Un endpoint disponible no demuestra que los datos estén sincronizados. Tampoco el silencio prueba una falla: contrastá las versiones aplicadas con las del origen. En catálogos, órdenes y envíos, estos controles permiten identificar qué quedó desfasado y dónde se cortó la sincronización.
El polling consulta una API a intervalos definidos para detectar cambios en catálogos, inventario, órdenes y envíos. En vez de descargar todo, pedí solo los cambios mediante updated_at, estados o cursores. Para monitorear la sincronización, compará los resultados con los cambios aplicados: así podés detectar qué quedó pendiente o fuera de la consulta.
El estado actual no muestra todas las transiciones, y el historial disponible depende de lo que conserve la fuente. Si la API no expone las eliminaciones, el polling no puede reconstruirlas.
| Aspecto | Polling | Webhooks |
|---|---|---|
| Quién define el momento | Definís frecuencia, alcance y ventanas de ejecución. | El origen decide cuándo intenta entregar. |
| Demora | Hasta el próximo intervalo, más el tiempo de consulta y procesamiento. | Casi en tiempo real, sujeto a entrega y procesamiento. |
| Uso de API | Hace consultas incluso sin cambios. | Evita lecturas periódicas vacías, pero requiere procesar entregas. |
| Cobertura recuperable | Permite volver a consultar registros o historial que la API todavía expone. | Depende de reintentos, replay o reconciliación posterior por API. |
Al monitorear, fijate qué cambios observás, con qué demora y qué huecos puede dejar cada ejecución.
Si consultás cada 5 minutos, un cambio puede esperar 2,5 minutos en promedio y hasta casi 5 minutos antes de la próxima ejecución, siempre que los cambios se distribuyan uniformemente. Para medir la latencia observada, sumá el tiempo de consulta, cola y procesamiento.
Elegí el intervalo según la demora que puedas tolerar. Priorizá inventario y órdenes activas. Para los envíos, concentrá las consultas en los que siguen en tránsito y reducí la frecuencia cuando lleguen a un estado final.
Consultar más seguido implica más lecturas, incluso cuando no hay cambios. Separá cuatro costos: cargos del proveedor por uso, consumo del rate limit, infraestructura de ejecución y mantenimiento. Monitoreá el consumo de API y respetá sus límites e indicaciones de espera. Los filtros incrementales reducen los datos transferidos, pero no eliminan las consultas vacías.
Guardá un checkpoint durable por tienda y recurso para registrar el avance de la sincronización. En cada ejecución, retomá desde ese punto, recorré todas las páginas y deduplicá por ID de evento o por ID de recurso más versión.
Si usás timestamps, agregá una ventana de solapamiento de 1 a 5 minutos para cubrir registros con la misma marca temporal o que aparecen tarde. Avanzá el checkpoint recién cuando los registros estén guardados o encolados de forma durable y puedan recuperarse tras una caída.
Configurá alertas para ejecuciones omitidas, cursores estancados y páginas repetidas sin avance. Para recuperar brechas, ejecutá un backfill sobre una ventana histórica acotada antes de que venza la retención del origen. A partir de ese checkpoint, medí qué cambios no entraron y cómo detectarlos a tiempo.
Compará cobertura, latencia y recuperación para catálogo, pagos, órdenes y envíos. Para cada dato, definí qué sistema manda, qué señal indica un desvío y qué brecha requiere reparación.
La elección depende de cuánto tarda cada método en detectar cambios, qué datos cubre y cómo permite recuperar lo que falta.
| Criterio | Webhooks | Polling |
|---|---|---|
| Latencia de detección | Baja si la entrega y el procesamiento funcionan. | Depende del próximo ciclo y de cuánto dure. |
| Uso de API y costo | Evita consultas vacías, aunque puede requerir lecturas de confirmación. | Consulta de forma periódica, incluso cuando no hay cambios. |
| Catálogo e inventario | Notifica altas, bajas y cambios de stock si el origen los expone. | Revisa registros modificados, pero no recupera eliminaciones que la API no expone. |
| Órdenes y pagos | Permite reaccionar rápido; conviene confirmar el estado en la API de origen. | Comprueba el estado actual, pero puede omitir transiciones intermedias. |
| Envíos | Permite avisar rápido ante cambios de tracking. | Detecta actualizaciones en el siguiente chequeo. |
| Observabilidad | Conecta evento, entrega, respuesta HTTP, reintentos y acción aplicada. | Conecta ciclo, ventana, páginas, cursor y resultado aplicado. |
| Recuperación de fallas | Los reintentos pueden agotarse. Para recuperar faltantes, requiere reentrega, replay o reconciliación por API. | Permite retomar desde un checkpoint y revisar diferencias mientras la API conserve los datos. |
| Duplicados y orden | Requiere deduplicación y control de actualizaciones atrasadas. | Puede repetir registros por ventanas superpuestas o por un manejo incorrecto del cursor. |
Medí las brechas de sincronización, no solo las entregas exitosas. Que un evento llegue no significa que el cambio se haya aplicado.
Separá entrega, procesamiento y concordancia entre origen y destino. Medí la antigüedad del cambio pendiente y la latencia de procesamiento en p95 y p99. Registrá respuestas 429, timeouts, reintentos agotados, duplicados y actualizaciones fuera de orden. En polling, detectá cursores estancados y registrá cuántas páginas se procesan por ciclo.
Ajustá las alertas a la urgencia y la actividad esperada. La ausencia de órdenes solo es sospechosa si esperabas ventas. Si el catálogo no cambia, verificá que los controles sigan ejecutándose. No calcules el porcentaje de eventos recibidos sin un conteo confiable del origen.
Ante un desvío, la traza tiene que mostrar dónde se interrumpió el flujo y cómo se corrigió.
Usá un identificador de correlación que conecte origen, tienda, integración y destino. Guardá el tipo y el ID de entidad, el event_id o cursor y los timestamps del cambio, la recepción, el inicio y la finalización del procesamiento. Registrá los intentos, los resultados, el estado de sincronización, la categoría del error y la recuperación aplicada. La traza debe mostrar si el cambio llegó al destino y si activó la acción esperada, no solo si terminó el worker.
Para webhooks, agregá metadatos de entrega, respuesta HTTP y próxima reentrega. Para polling, registrá la ventana, las páginas, los códigos, las cantidades y los checkpoints anterior y nuevo. Conservá solo los datos necesarios, con cifrado, acceso restringido y retención limitada. Ocultá credenciales, tokens, teléfonos y direcciones.
Usá la traza para localizar el cambio pendiente, recuperar la orden, el stock o el envío y verificar el resultado. Al reprocesar, mantené los controles idempotentes: repetir un intento no debe duplicar una orden, un descuento de stock ni un aviso.
Tras comparar latencia, costo y recuperación, elegí webhooks, polling o ambos según la urgencia del dato y tu capacidad para recuperarlo.
Si necesitás velocidad y cobertura, combiná ambos métodos. Poné un límite a los reintentos y usá espera exponencial con jitter. Respetá Retry-After, aislá las fallas que necesiten revisión y separá la reparación de datos del envío de mensajes al cliente.
Programá la reconciliación con una ventana de reproceso que no supere el límite de retención de la API. Configurá alertas para detectar brechas persistentes.
En este esquema, Burbuxa necesita datos sincronizados y trazables de productos, inventario, clientes, órdenes, descuentos y envíos para responder correctamente en WhatsApp e Instagram. Combinar webhooks y polling es una recomendación de diseño: no garantiza la sincronización.
Medí los cambios efectivamente aplicados: stock vigente, estados de órdenes correctos y avisos de envío sin duplicados. La señal de éxito es actuar con datos correctos, no acumular más eventos.
Priorizá según el impacto en la operación y las finanzas: empezá por los webhooks de pagos exitosos para detectar ingresos y activar acciones automáticas. Después, integrá los pedidos y las actualizaciones de inventario para evitar sobreventas y mantener el stock al día.
Usá polling cada 6 a 12 horas como capa de reconciliación: permite recuperar eventos perdidos y corregir inconsistencias en el catálogo y los datos de clientes. Burbuxa automatiza este flujo de sincronización.
Combiná webhooks con polling cada 6 a 12 horas para detectar y recuperar eventos perdidos. Registrá métricas, logs y trazas de cada solicitud. Configurá alertas cuando aumenten los errores 5xx o los tiempos de respuesta.
Guardá en una cola los eventos que sigan fallando después de varios reintentos. Además, conciliá a diario los pedidos y los ingresos con la fuente original para detectar diferencias o datos faltantes en Burbuxa, incluso si no hay historial de eventos.
Implementá idempotencia con identificadores únicos, como event_id o transaction_id. Antes de ejecutar una acción de negocio, consultá tu base de datos o caché para verificar si ese ID ya se procesó. Si ya está registrado, descartá la solicitud repetida y respondé con 200 OK.
Si el evento no incluye un ID único, usá una regla secundaria de deduplicación: combiná recipient_id, event_type y object_id dentro de una ventana temporal acotada.