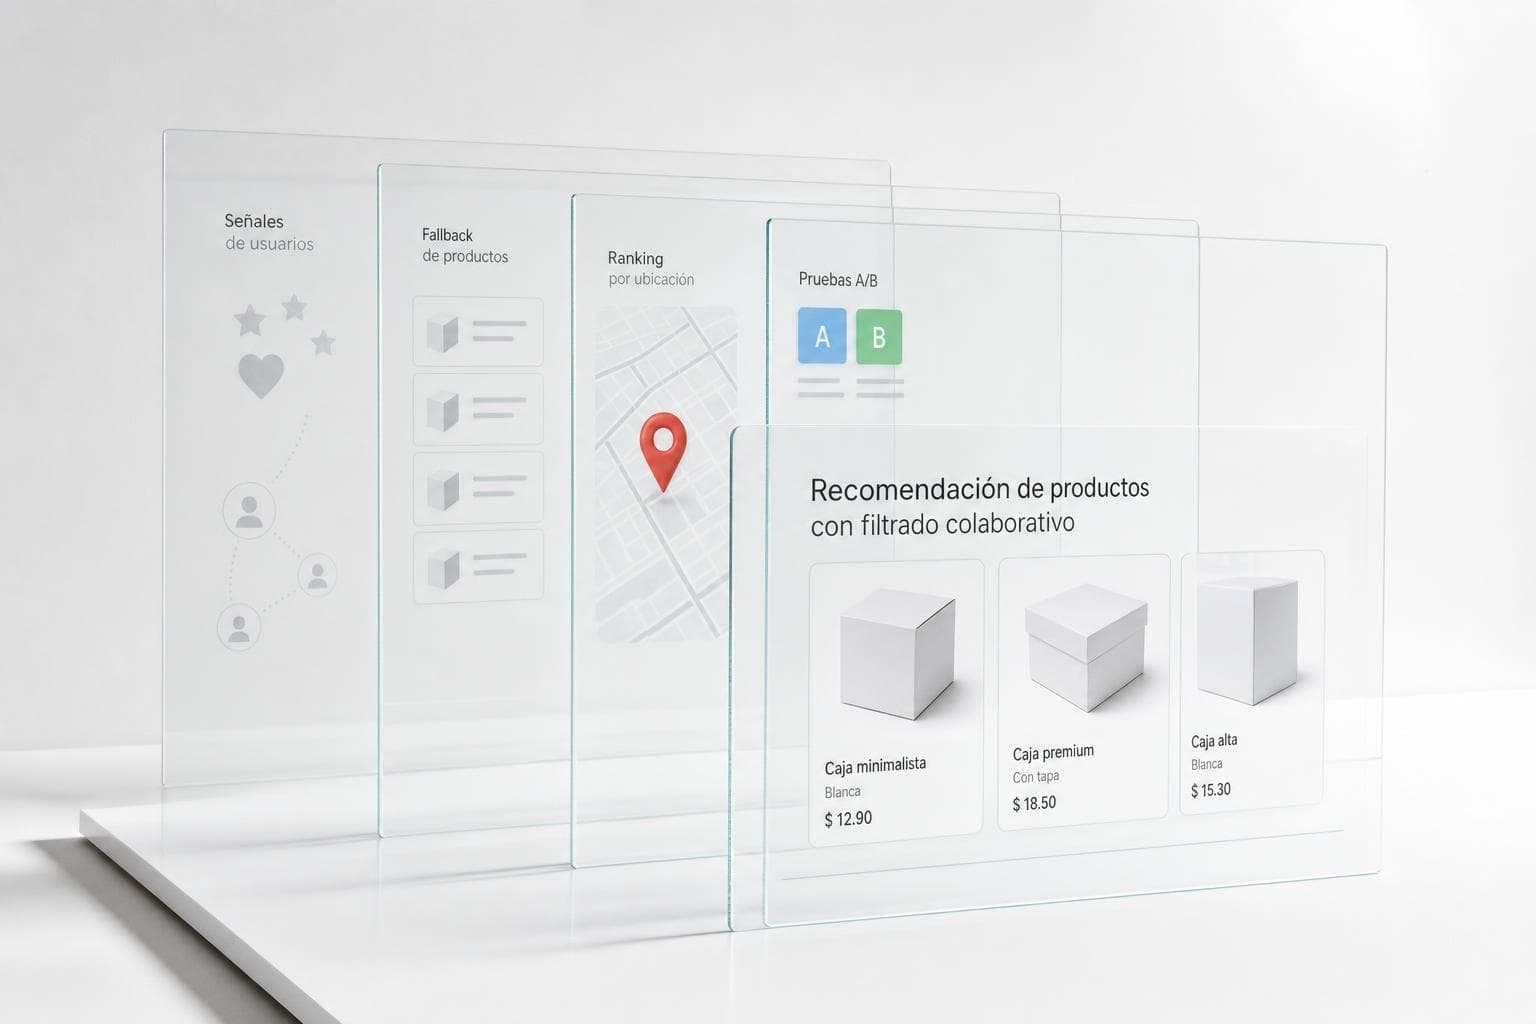
Si vendo online, el filtrado colaborativo me sirve para mostrar productos usando comportamiento de compra y navegación, no solo datos del catálogo. En simple: miro qué ven, agregan al carrito y compran otras personas, y con eso armo sugerencias para cada visita, cada carrito y cada chat.
Lo más útil del enfoque es esto:
Dicho de otro modo: el motor puede ser parecido, pero el ranking, los filtros y la métrica cambian según el momento. No rankeo igual en una ficha de producto que en checkout o en un mensaje de reposición.
Si lo bajo a pasos concretos, yo lo ordenaría así:
Hay tres enfoques, y no dan lo mismo:
| Enfoque | Qué hago | Dónde suele encajar |
|---|---|---|
| Basado en usuarios | Busco personas con conducta parecida | Cuando tengo mucho historial por cliente |
| Basado en productos |
| Busco artículos que aparecen juntos |
| PDP, carrito y recomendaciones simples |
| Basado en modelos | Estimo interés con patrones latentes | Cuando ya tengo más volumen de datos |
En la práctica, para muchas tiendas el punto de partida más directo es el enfoque basado en productos. Suele ser más fácil de explicar, más simple de activar y funciona bien en bloques como “Productos similares” o “Comprados juntos”.
También me quedo con una idea central del artículo: una recomendación buena no es la que consigue más clics, sino la que mueve negocio sin meter fricción. Por eso, en checkout conviene mostrar 2 o 3 sugerencias puntuales, no una grilla larga. Y en chat, primero hay que entender necesidad, talle, compatibilidad o presupuesto antes de sugerir cualquier cosa.
Si necesito una regla simple para empezar hoy, usaría esta:
Con esa base, el resto del artículo baja el tema a datos, señales, ubicaciones, chats y medición para que yo pueda pasar de recomendaciones genéricas a recomendaciones con impacto en conversión, AOV y recompra.
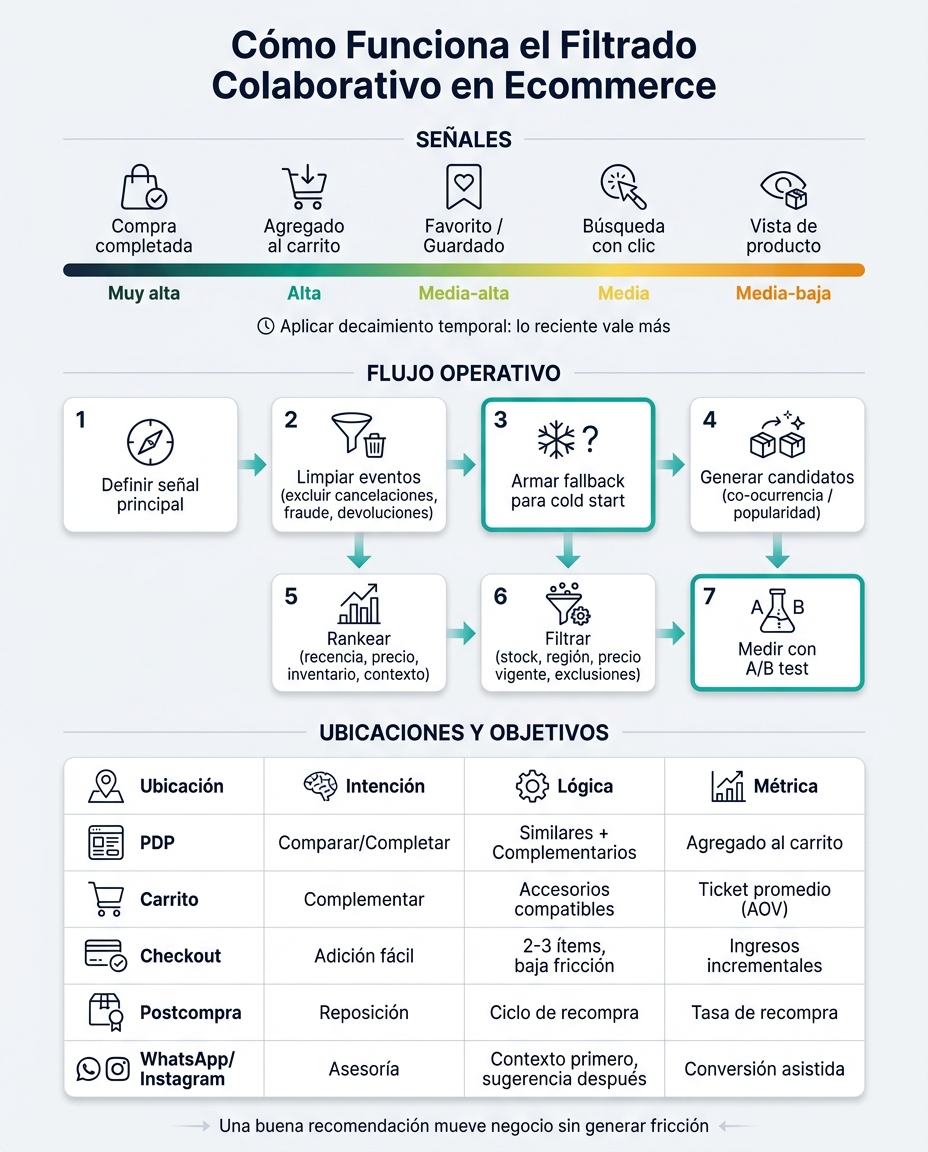
Flujo de Filtrado Colaborativo: De Señales a Recomendaciones
Pensalo como una matriz enorme: en las filas tenés clientes o sesiones, en las columnas productos, y en cada celda la intensidad de interacción. En ecommerce, esa matriz casi siempre es dispersa: casi nadie interactúa con todo el catálogo. El trabajo del modelo es leer ese patrón incompleto y estimar qué podría interesarle a una persona aunque todavía no haya interactuado con ciertos artículos.
A partir de esa base, el paso siguiente es definir qué eventos importan más.
Si tu tienda está conectada por API, conviene centralizar estos datos:
customer_id o session_idproduct_idevent_typePara visitantes anónimos, persistí un session_id de primera parte y unilo al customer_id cuando haya login o compra, siempre con consentimiento y privacidad en regla.
Antes de meterse en las señales, hay una distinción que cambia bastante el enfoque. El sistema puede recibir señales explícitas, como una calificación, un favorito o una reseña, y también señales implícitas, que surgen de acciones como ver un producto, sumarlo al carrito o comprarlo. En ecommerce suele haber muchas más señales implícitas, pero también son más ambiguas. Una vista, por ejemplo, puede indicar interés, comparación o simplemente un clic accidental. Por eso no alcanza con contar eventos: hay que ponderarlos según la intención que representan.
La matriz no solo guarda eventos. También les da un peso. Y eso tiene sentido: no todas las interacciones dicen lo mismo.
Como punto de partida, el orden relativo suele ser este: compra > carrito > favorito > búsqueda con clic posterior > vista. Ahora bien, eso no es una ley escrita en piedra. Son hipótesis iniciales que cada tienda debería ajustar con sus propios datos.
Además del peso por tipo de evento, conviene aplicar decaimiento temporal. En pocas palabras: los eventos recientes deberían valer más que los viejos. El ritmo de ese decaimiento depende mucho de la categoría. En moda, el interés puede cambiar de una semana a otra. En electrónica o productos durables, en cambio, ese interés puede sostenerse durante más tiempo.
También hace falta poner límites a la repetición. Diez vistas del mismo producto dentro de una sola sesión no deberían contar como diez veces más interés. Si no controlás eso, el modelo puede inflar señales débiles y terminar leyendo mal la intención.
| Señal | Fuerza de intención | Confiabilidad | Uso recomendado |
|---|---|---|---|
| Compra completada y retenida | Muy alta | Alta | Señal positiva principal para entrenamiento y ranking |
| Compra repetida o reposición | Muy alta | Alta en consumibles | Modelos de reposición y ciclo de vida |
| Agregado al carrito | Alta | Media | Ranking en tiempo real, recuperación de carrito |
| Favorito o guardado | Alta | Media a alta | Ranking y mensajería disparada |
| Búsqueda con clic posterior | Media a alta | Media | Recomendaciones de sesión y generación de candidatos |
| Vista de producto | Media a baja | Media a baja | Personalización de corto plazo y similitud entre productos |
| Devolución, cancelación o fraude | Negativa o de exclusión | Alta tras validación | Excluir de etiquetas positivas o aplicar penalización |
Antes de entrenar cualquier modelo, limpiá los datos. Eso incluye deduplicar eventos con IDs estables, excluir órdenes canceladas, fraudulentas y devueltas, y decidir si el modelo va a trabajar con el producto padre o con la variante puntual.
Cuando no hay historia suficiente, el filtrado colaborativo no puede puntuar bien esos casos usando solo comportamiento. Ahí aparece el problema clásico de cold start. Para un usuario nuevo o anónimo, el sistema puede apoyarse en más vendidos por categoría, popularidad regional o productos ligados al contexto de la sesión. Para un SKU nuevo sin interacciones, la salida suele estar en los atributos del catálogo: categoría, marca, rango de precio o compatibilidad, más una exposición controlada mediante reglas de merchandising.
Ese fallback siempre tiene que respetar stock, región, precio vigente y exclusiones del catálogo. Después, a medida que entran más interacciones, el sistema puede ir subiendo de a poco la proporción de recomendaciones personalizadas frente a las genéricas.
Con los datos limpios y el fallback ya definido, el paso siguiente es decidir dónde mostrar cada recomendación.
En la práctica, el flujo se arma en tres capas: candidatos, ranking y filtros finales.
Primero generás candidatos con co-ocurrencia o popularidad. Después los rankeás sumando señales como recencia, precio e inventario. Y al final aplicás stock, región, precio y exclusiones como filtros finales, no como reemplazo del ranking.
Con los candidatos ya filtrados y rankeados, la ubicación pasa a definir el objetivo de cada recomendación. El modelo puede ser el mismo; lo que cambia es cómo rankeás y dónde lo mostrás. Cada espacio responde a una intención distinta: descubrir, comparar, complementar o recomprar.
En la ficha de producto (PDP) pueden convivir dos bloques, pero no cumplen la misma función. "Productos similares" sirve para mostrar alternativas y ayudar a comparar o sustituir. En cambio, "También te puede interesar" o "Completá tu compra" apunta a complementos: una funda para el teléfono, un cinturón para el pantalón o un hidratante compatible con el limpiador que la persona está mirando.
Antes de rankear, aplicá los filtros operativos que ya definiste. Por ejemplo: una zapatilla de $65.000 puede mostrar similares entre $50.000 y $80.000, con talle disponible y entrega en su zona.
En páginas de categoría, "Más vendidos de la categoría" suele funcionar bien con visitantes nuevos. Para usuarios recurrentes con historial, conviene más usar afinidad y productos vistos recientemente.
Cuando la persona ya tomó una decisión, la lógica cambia: deja de comparar y pasa a complementar.
En carrito y en la pantalla de pago (checkout), conviene priorizar complementos compatibles, excluir lo que ya se agregó y limitar el checkout a productos de baja fricción.
Baymard recomienda priorizar artículos del mismo tema o familia, usar etiquetas contextuales como "Combinan con tu compra" y evitar alternativas al producto ya seleccionado, porque generan fricción sin aportar valor.
Acá, dos o tres sugerencias muy precisas suelen rendir mejor que una grilla larga. Y la métrica a mirar no es solo el CTR. También importan la tasa de agregado y el ticket promedio.
Después de la compra, el objetivo vuelve a cambiar. Ya no se trata de empujar una conversión inmediata, sino de activar una recompra o una reposición. En consumibles, conviene estimar el intervalo de uso y enviar el recordatorio en el momento justo. En durables, sirve más recomendar accesorios compatibles. Antes de mostrar cualquier sugerencia, chequeá las condiciones operativas y excluí artículos comprados hace poco, salvo que tengan recompra frecuente.
La mejor ubicación depende de la intención y de la métrica que querés mover.
| Ubicación | Intención | Lógica recomendada | Riesgo principal | Métrica principal |
|---|---|---|---|---|
| Inicio | Descubrir | Más vendidos para nuevos; afinidad y vistos recientemente para recurrentes | Productos irrelevantes sin historial | CTR y visitas a ficha |
| Listado de categoría | Explorar | Más vendidos, afinidad y vistos recientemente | Interferir con filtros o saturar el listado | Agregado al carrito y conversión |
| Ficha de producto | Comparar o completar | Similares para sustitución; complementarios para venta cruzada | Alternativas que distraen del producto principal | Agregado al carrito y conversión |
| Carrito | Complementar | Comprados juntos y accesorios compatibles | Ofertas irrelevantes que generan fricción | Tasa de agregado y ticket promedio |
| Pantalla de pago | Adición de bajo esfuerzo | Solo complementos pequeños y compatibles | Interrumpir el flujo de pago | Ingresos incrementales y finalización |
| Postcompra | Reposición y próxima compra | Reposición por ciclo y complementos | Contactar demasiado pronto o recomendar ya comprados | Tasa de recompra e ingresos por cliente |
Usá esta tabla para definir la métrica principal de cada bloque. No conviene mezclar señales de ficha de producto, carrito y postcompra en un solo indicador.
La lógica del filtrado colaborativo también funciona en WhatsApp e Instagram. La diferencia está en que el chat suma contexto conversacional en tiempo real. En otras palabras, las mismas señales de compra se mezclan con preguntas y respuestas del momento, y eso permite ajustar la recomendación justo cuando ocurre la conversación, sin tocar el motor de recomendación de base.
En WhatsApp, existen diversas estrategias para aumentar ventas donde las recomendaciones suelen rendir mejor: la recuperación de carrito, el recordatorio de reposición y la venta asistida.
En recuperación de carrito, el mensaje tiene que mostrar el producto exacto, con precio y stock en tiempo real. Si suma valor, también se puede incluir una alternativa parecida y aclarar condiciones como envío, cuotas o la promo vigente.
En reposición, si el historial marca un ciclo de compra, el sistema puede reactivar el pedido en el momento esperado. Acá el timing pesa mucho. Si el recordatorio llega antes de tiempo, molesta. Si llega tarde, pierde sentido.
En venta asistida, el orden cambia todo. Primero hay que entender necesidad, presupuesto y restricciones. Después sí, filtrar el catálogo. Una pregunta corta de calificación suele funcionar mejor que recomendar a ciegas. Y si no existe una coincidencia exacta, conviene decirlo de frente y mostrar opciones parecidas, en lugar de cambiar automáticamente la variante que pidió la persona. En todos los casos, hay que respetar las ventanas de mensajería, el consentimiento y las políticas que correspondan.
En Instagram, la señal suele ser más débil. Por eso, la recomendación debería esperar una confirmación explícita.
En Instagram, una respuesta a una historia, un DM o una consulta sobre un anuncio muestra interés, pero todavía no alcanza para recomendar algo con criterio. Antes de ordenar opciones, el sistema debería pedir más contexto: talle, tono, compatibilidad, rutina o presupuesto.
Las señales más confiables son las directas. Una consulta sobre talle o compatibilidad pesa más que un like o una vista. Para rutinas o bundles, conviene detectar primero el objetivo y aplicar reglas de compatibilidad y disponibilidad antes de mostrar productos. Si hay dudas, es mejor preguntar que asumir. Y también sirve dejar una salida simple para corregir la recomendación si no encajó.
Para que estas recomendaciones funcionen bien, el sistema necesita el mismo dato operativo que usa la tienda, pero sincronizado al instante. Si eso no pasa, aparecen los errores más comunes: ofrecer una variante sin stock, mostrar un precio viejo o aplicar un descuento vencido.
Burbuxa funciona como una capa unificada que sincroniza productos, pedidos, clientes, inventario, descuentos y políticas en tiempo real. Esa información alimenta los flujos de recuperación de carrito, venta cruzada, reposición y reseñas tanto en WhatsApp como en Instagram DMs desde un mismo sistema.
Esa capa unificada evita errores de stock, precio y pedido. Cuando el asistente sabe qué compró la clienta o el cliente, qué dejó en el carrito y qué stock hay en ese momento, la recomendación deja de sonar genérica y pasa a sentirse como asesoría.
Con la capa de datos unificada, el paso siguiente es medir respuesta, conversión asistida y recompra por canal.
Después de definir dónde aparecen las recomendaciones, toca medir cuánto suman de verdad.
Con los flujos ya armados, separá dos frentes: calidad del ranking e impacto comercial. La primera parte se mira con métricas offline. La segunda solo se confirma con un experimento controlado. Mezclar ambas cosas es el error más común: un modelo puede mostrar un ranking técnico mejor y, aun así, bajar los ingresos por sesión, aunque sus métricas de evaluación hayan subido.
Las métricas offline sirven para comparar versiones antes de salir a producción y para detectar modelos flojos. Pero no prueban impacto comercial, porque arrastran sesgos de exposición y popularidad. La decisión de negocio tiene que apoyarse en tests online.
Primero validá el ranking. Después medí negocio.
Las métricas online cambian según la ubicación. En la PDP, el foco suele estar en el CTR de recomendaciones y en la tasa de agregado al carrito. En el carrito, importan más el attach rate y el ticket promedio (AOV). En postcompra, manda la tasa de recompra.
En recuperación de carrito, reposición y venta asistida, la vara cambia con la automatización de la conversación. Además de las bajas y las quejas, conviene seguir la tasa de respuesta, los clics en enlaces o tarjetas y la compra atribuida. Un aumento en CTR, por sí solo, no alcanza. Si no mejora el ingreso por sesión, no es un buen resultado.
El test A/B tiene que comparar el recomendador contra un grupo base bien claro: más vendidos, reglas manuales o ausencia del bloque. La randomización debe hacerse a nivel usuario, con una ventana de atribución fija declarada antes del lanzamiento. Por ejemplo: 24 horas para recuperación de carrito y 7 días para recomendaciones en PDP.
Después, no mires solo el promedio general. Los resultados tienen que abrirse por:
¿Por qué? Porque un modelo puede mejorar en móvil y empeorar en escritorio. O andar bien en WhatsApp con clientes recurrentes y generar más quejas entre contactos nuevos.
Antes de mostrar cualquier variante, aplicá controles de seguridad concretos. Excluí productos sin stock o con inventario incierto. Controlá descuentos que coman margen. Limitá la repetición de los mismos productos más vendidos para no concentrar todo el tráfico en pocos ítems. Y fijá límites de frecuencia en WhatsApp e Instagram.
Reembolsos, cambios de pedido y productos regulados piden revisión humana. Si una variante sube el attach rate pero también hace subir devoluciones o bajas, descartala.
Usá esta tabla para elegir una métrica principal por canal y no mezclar objetivos.
| Métrica | Definición | Uso para decidir | Ubicación donde más importa |
|---|---|---|---|
| Precision@K | Productos relevantes entre los primeros K resultados | Si la lista tiene demasiados productos irrelevantes | PDP, carrito |
| Recall@K | Proporción de productos relevantes recuperados en los primeros K | Si el sistema omite opciones que el cliente podría comprar | Categoría, inicio |
| NDCG@K | Relevancia ponderada por posición | Si los mejores productos aparecen primero | PDP, móvil |
| MAP@K | Precisión promedio a lo largo de los aciertos del ranking | Comparar listas con varios aciertos repartidos | Categoría, descubrimiento |
| MRR | Rango recíproco del primer resultado relevante | Qué tan rápido aparece una respuesta útil | WhatsApp, venta asistida |
| Cobertura | Proporción del catálogo elegible que llega a ser recomendada | Detectar concentración excesiva en más vendidos | Inicio, categoría, omnicanal |
| Diversidad | Variedad de la lista | Evitar recomendaciones repetitivas | PDP, carrito |
| Novedad | Exposición a productos poco familiares | Favorecer el descubrimiento sin perder relevancia | Inicio, Instagram |
| Latencia / Tiempo de respuesta | Tiempo que tarda el sistema en devolver recomendaciones | Evitar demoras en la PDP o en la respuesta por chat | PDP, WhatsApp, Instagram |
| CTR de recomendaciones | Clics divididos por impresiones | Medir el interés inicial | Todos los módulos |
| Ingresos por sesión | Ingresos divididos por sesiones elegibles | Comparar valor incremental real | PDP, carrito, WhatsApp |
| Attach rate | Pedidos con al menos un producto recomendado dividido por pedidos totales | Medir el éxito de la venta cruzada | Carrito, complementos en PDP |
| Tasa de recompra | Clientes que vuelven a comprar en un período definido | Evaluar el valor durable de las recomendaciones | Postcompra, WhatsApp |
| Tasa de bajas | Bajas divididas por mensajes entregados | Proteger el permiso de mensajería | WhatsApp, Instagram |
| Tasa de queja | Quejas divididas por conversaciones | Detectar recomendaciones dañinas o no deseadas | WhatsApp, Instagram |
| Tasa de devolución o reembolso | Órdenes con devolución o reembolso de productos recomendados divididas por esas órdenes | Detectar mala selección o promesas engañosas | PDP, chat, postcompra |
La idea que ordena todo esto es simple: arrancá con un objetivo de negocio claro por ubicación, usá señales de alta intención, ajustá la lógica de ranking a cada contexto, conectá las recomendaciones con los flujos de WhatsApp e Instagram cuando esos canales mueven la compra y medí impacto incremental contra un grupo base, no solo con scores del modelo offline.
Conviene cuando ya tenés suficiente historial de interacciones y tráfico. ¿Por qué? Porque este enfoque se apoya en patrones de compra de usuarios parecidos para sugerir productos.
No suele funcionar tan bien con productos nuevos o catálogos muy de nicho, por el problema de arranque en frío. En esos casos, por lo general rinde mejor el filtrado basado en contenido o un sistema híbrido.
Si tenés poco historial o sumaste productos nuevos, el problema principal es el arranque en frío. Dicho simple: el algoritmo todavía no juntó datos de comportamiento suficientes como para decidir qué mostrar primero.
En esos casos, conviene ir por recomendaciones basadas en contenido. Este enfoque mira atributos, metadatos, descripciones y también la similitud visual entre productos. Burbuxa hace esto más simple al sincronizar tu catálogo y mezclar embeddings visuales con el contexto del usuario, para recomendar productos nuevos desde el primer día.
Para mantener la precisión y la efectividad, lo mejor es reentrenar los modelos todos los días.
Eso ayuda a que el sistema se ajuste a cambios en el catálogo, tendencias de temporada y nuevos patrones de comportamiento de tus clientes.
Además, conviene seguir de cerca la relevancia de las sugerencias de forma continua. Si el rendimiento baja, es una señal clara de que toca reentrenar el modelo.