Ocultar un nombre no alcanza para anonimizar datos. En mi tienda online, parto de una regla: conservar solo lo que necesito y revisar si todavía puedo identificar a un cliente.
Para reducir la exposición de clientes, pedidos, chats y campañas de marketing, elijo entre 5 técnicas:
<u>Menos detalle no significa anonimato.</u> Un grupo de 20 clientes, por ejemplo, no garantiza que nadie pueda identificarlos. Si puedo recuperar una identidad o deducirla mediante cruces, trato esos registros como datos personales bajo la Ley 25.326.
Comparación rápida
| Técnica | Qué me permite hacer | Qué debo revisar |
|---|---|---|
| Enmascarado | Mostrar menos información | Datos que siguen visibles |
| Seudonimización | Vincular registros | Acceso a la tabla de identidades |
| Agregación | Medir resultados colectivos | Grupos pequeños y cruces entre reportes |
| Generalización | Analizar con menos precisión | Combinaciones que revelan personas |
| Tokenización | Mantener referencias entre sistemas | Recuperación y correlación de tokens |
Antes de compartir datos, combino las técnicas según la tarea, separo las claves, limito accesos y fijo plazos de conservación. Después, pruebo si los datos aún permiten reconocer a alguien.
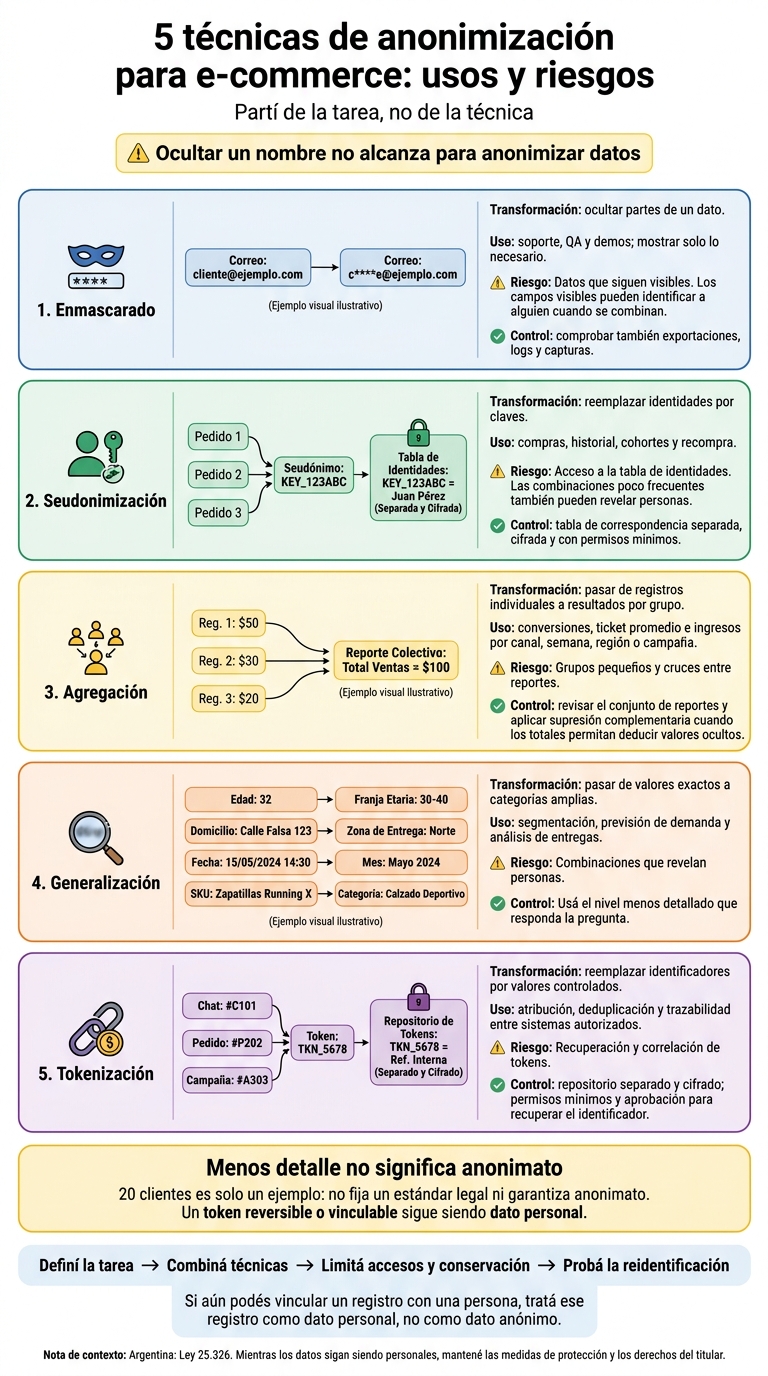
5 técnicas de anonimización para e-commerce: usos y riesgos
En los registros de clientes, pedidos, chats y campañas, los identificadores directos - DNI, correo, teléfono o dirección completa - permiten reconocer a un cliente. Los cuasiidentificadores, como zona, edad, horario de compra y producto adquirido, pueden revelar su identidad cuando se combinan.
Una base es anónima solo si no permite identificar razonablemente a una persona, incluso al cruzarla con otras fuentes. En los chats, borrar el nombre del contacto no alcanza: el texto libre puede seguir teniendo datos que permitan identificarlo.
Si podés recuperar la identidad mediante una tabla de correspondencias o una búsqueda interna, tratá el conjunto como datos personales. Guardá esa tabla por separado, limitá el acceso y registrá quién la usa.
En Argentina, la Ley 25.326 exige medidas técnicas y organizativas para impedir accesos o usos no autorizados. También contempla la disociación de datos para fines estadísticos o científicos. Sumá las recomendaciones de la AAIP según el tratamiento y las transferencias involucradas.
Cuando solo necesitás mostrar un dato, sin vincularlo, el enmascarado es la opción más simple. Aplicalo por defecto en QA, soporte, demos y exportaciones: si el equipo no necesita el dato completo, no se lo muestres. Esto abarca datos de clientes, pedidos, chats y exportaciones de campañas de marketing en WhatsApp.
Enmascará nombres, correos, teléfonos, domicilios, referencias de pago y números de pedido. Ajustá lo que mostrás según el uso: en QA, conservá solo el formato; en demos, usá datos sintéticos; en soporte, mostrá lo mínimo. Para analítica, quitá los identificadores directos y generalizá los demás campos lo necesario para que no se pueda identificar a una persona a partir del registro. Mantené el prefijo +54 solo si necesitás validar el formato internacional.
Revisá los campos en conjunto, no solo por separado. Un apellido poco frecuente, el dominio de correo de una empresa chica o unos pocos dígitos de un teléfono pueden identificar a alguien al cruzarlos con la fecha, el importe y el producto.
Enmascará los datos personales en toda la conversación: mensajes citados, notas del agente, adjuntos y metadatos. La detección automática puede ayudar, especialmente al integrar una plataforma de WhatsApp para TiendaNube, pero revisá a mano las muestras que uses en demos o compartas con terceros.
Separá producción de pruebas y limitá el acceso a los datos originales según el rol. Comprobá que el enmascarado se mantenga en exportaciones, logs y capturas: ocultar un campo en pantalla no alcanza. Registrá los accesos y fijá una fecha de vencimiento para las copias de QA. Nunca incluyas contraseñas, códigos de seguridad de tarjetas ni enlaces de recuperación en esos entornos.
Si necesitás volver a unir registros sin mostrar datos directos, seguí con la seudonimización.
Para mantener la continuidad entre pedidos, soporte y fidelidad, reemplazá los IDs de clientes y de esos registros por seudónimos estables. Conservá solo los campos que necesitás para analizar cohortes, recompra, devoluciones y fraude.
Usá un seudónimo estable por cliente y uno único por pedido. Compartilos solo entre los sistemas autorizados para esa finalidad. Para otros usos, generá claves distintas.
Una combinación poco frecuente de compras, ubicación y hora puede identificar a un cliente.
Para cohortes, guardá mes y categoría; reservá fecha completa y SKU solo para análisis que lo requieran.
Para equilibrar el detalle de los datos y la privacidad, separá la tabla de correspondencia y controlá quién puede acceder a ella.
Guardá la tabla que vincula seudónimos e identidades por separado, cifrada y con permisos mínimos. Registrá y auditá los accesos a esa tabla.
Si querés medir campañas automatizadas en WhatsApp sin analizar registros individuales, seguí con la agregación.
Usá la agregación para comparar conversiones, ticket promedio, ingresos por canal y volumen de consultas por semana, región o campaña. En soporte, agrupá las conversaciones por tema y período, sin incluir mensajes ni identificadores. Esta práctica es fundamental al gestionar atención al cliente en ecommerce para proteger la privacidad del usuario.
Hacé los cálculos dentro de un sistema controlado y exportá solo los resultados:
Conversión = pedidos ÷ sesiones válidas × 100; ticket promedio = ingresos de pedidos ÷ cantidad de pedidos.
Mostrá siempre el denominador y redondeá solo cuando no cambie la lectura.
Un reporte agregado no es automáticamente anónimo. Los grupos pequeños y los cruces entre informes pueden revelar personas. Por ejemplo, comparar un total con un subtotal casi idéntico permite deducir resultados ocultos. Por eso, revisá el conjunto de reportes, no solo cada celda por separado.
Definí un mínimo de clientes distintos según la sensibilidad del dato y quién va a ver el informe.
20 clientes es solo un ejemplo: no fija un estándar legal ni garantiza anonimato.
Si el riesgo es mayor, ampliá el período o la región y exigí grupos más grandes.
Suprimí las celdas pequeñas y las métricas derivadas que permitan deducir sus valores. Si ocultás una cantidad, pero publicás los ingresos exactos, esa cantidad puede seguir siendo deducible. Aplicá supresión complementaria cuando los totales permitan calcular el valor oculto.
Antes de compartir el reporte, documentá el umbral, el plazo de conservación y la revisión humana. Limitá los accesos y registrá tanto los accesos como las exportaciones.
Cuando necesitás más detalle que un agregado, la generalización reemplaza valores precisos por categorías más amplias, sin mostrar los datos exactos.
Podés pasar edad a franjas etarias, domicilio o código postal a zonas de entrega, fecha y hora de compra a semanas o meses, y SKU o navegación a categorías de producto.
El nivel de detalle depende de la tarea:
Para segmentación, franjas etarias y actividad mensual; para prever demanda, semanas y familias de productos; para analizar entregas, zonas y fechas de despacho.
Generalizar también significa perder precisión:
Un mes no sirve para ver horas pico y una región amplia puede ocultar diferencias de reparto.
Usá el nivel menos detallado que responda la pregunta. Reservá los datos exactos para tareas operativas con acceso justificado.
Revisá las combinaciones de ubicación, franja etaria y hora de compra, sobre todo si pueden cruzarse con datos de fidelización, pedidos o fuentes públicas. Si permiten distinguir a pocos clientes, agrupá más antes de compartir.
Definí reglas fijas para cada campo y, según el riesgo, un mínimo de clientes distintos por combinación. Si no llegás a ese mínimo, ampliá la zona, uní franjas o quitá la hora.
Compartí solo la vista generalizada y bloqueá los cruces sin permiso con registros detallados. Documentá las reglas y revisalas cada vez que sumes períodos, productos o fuentes.
Si necesitás reemplazar identificadores sin perder trazabilidad, pasá a la tokenización.
Cuando necesitás cruzar chats, pedidos y campañas sin mostrar los identificadores originales, usá tokenización.
La tokenización reemplaza IDs de conversaciones, contactos de campaña y referencias de pago por valores controlados. Así podés conservar las relaciones entre registros sin exponer el identificador original.
Definí un token de cliente, otro por conversación y otro por contacto de campaña. Guardá solo las relaciones necesarias para conectar chats, pedidos y conversiones.
Los tokens estables permiten seguir compras sucesivas, pero también facilitan la correlación entre registros. Si no necesitás ese historial, usá tokens por proyecto o de corta duración. Así mantenés la trazabilidad sin dar acceso al dato original.
En un flujo con Burbuxa, tokenizá los identificadores antes de entregar datos a analítica o automatización. Compartí solo los campos necesarios: canal, campaña, estado del pedido y resultado de atención.
Un token reversible o vinculable sigue siendo dato personal, no información anónima. En Argentina, no lo presentes como dato disociado si todavía permite identificar a una persona.
Antes de compartirlo, verificá los enlaces entre chats y pedidos, los duplicados y los errores de atribución. Revisá también si las fechas, las compras poco frecuentes o los mensajes permiten reconocer al cliente. Controlar los vínculos no equivale a anonimizar los datos.
Guardá la tabla de correspondencias en un repositorio separado y cifrado, y protegé las claves. Aplicá permisos mínimos, autenticación multifactor y un proceso de aprobación para recuperar el identificador original.
Registrá accesos, exportaciones y recuperaciones en logs inmutables, sin incluir tokens sensibles ni valores originales. Rotá las claves o los tokens cuando corresponda y conservá los enlaces autorizados. Estos controles sirven cuando necesitás trazabilidad entre chats y campañas sin dar acceso directo a los identificadores.
Partí de la tarea, no de la técnica. Definí qué necesitan ver los equipos de soporte, marketing, analítica y operaciones. ¿Deben conectar registros? ¿Cuánta precisión necesitan? La seguridad depende de los datos, los accesos y el riesgo de reidentificación.
Esta tabla lleva esas decisiones a casos concretos de e-commerce.
| Tipo de dato | Objetivo | Técnica | Cruce entre sistemas | Riesgo residual | Uso posible |
|---|---|---|---|---|---|
| Nombre, correo y teléfono | Soporte y pruebas | Enmascarado | Generalmente innecesario | Identificación por campos visibles | Formato y contexto; no contacto directo |
| Clientes y pedidos | Analizar compras e historial | Seudonimización | Clave común autorizada | Reidentificación; sigue siendo dato personal. | Cruces e historial |
| Envíos, clics, ventas e ingresos | Medir campañas | Agregación | Sin identidad en el reporte | Grupos pequeños o cruces entre reportes | Métricas colectivas |
| Ubicación, edad, fecha e importe | Segmentar | Generalización | Opcional | Combinaciones poco frecuentes | Tendencias y segmentos |
| IDs de chats, campañas, pedidos o sesiones | Mantener referencias | Tokenización | Solo sistemas autorizados | Acceso a la bóveda o resolución de tokens | Atribución y deduplicación |
Conservá precisión solo cuando aporte valor. Si quedan pocos registros, ampliá la categoría.
Combiná las técnicas según el destino de los datos: seudonimizá para unir clientes y pedidos, generalizá ubicación e importe, y agregá antes de compartir. Validá el resultado: sumar transformaciones no garantiza anonimato. Después, revisá permisos, retención y accesos.
Después de aplicar enmascarado, seudonimización, agregación, generalización o tokenización, comprobá si todavía se puede reidentificar a una persona. Evaluá el conjunto desde tres perspectivas: la de un analista, la de un empleado con acceso a otros sistemas internos y la de un destinatario externo con información pública. Probá identificar a una persona concreta, vincular sus registros e inferir información sobre ella. Registrá los cruces intentados, los registros expuestos y las correcciones aplicadas.
No hay un umbral universal de riesgo aceptable. Justificá el criterio según el uso y repetí la evaluación cuando cambien los datos, los destinatarios o las integraciones.
Si el cruce sigue siendo posible, separá de inmediato las tablas de correspondencia y las claves. No entregues a un tercero los datos junto con la tabla de vinculación. Antes de compartir el conjunto, revisá los metadatos, los nombres de archivos, las URLs y los comentarios de las planillas. Asignale un responsable, una finalidad y un plazo de conservación.
Para lograr una disociación efectiva, eliminá de forma segura los datos de origen y los vínculos identificadores cuando ya no aporten valor operativo y no haya obligaciones de conservación. Esto incluye exportaciones, entornos de prueba, logs y backups. Documentá su eliminación o vencimiento y evitá que una restauración recupere datos que debían borrarse. Borrar la base activa no demuestra anonimato: pueden quedar atributos o fuentes externas que permitan identificar a una persona.
En Argentina, documentá la finalidad y el fundamento legal del tratamiento. Mientras los datos sigan siendo personales, garantizá los derechos del titular conforme a la Ley 25.326. Conservá evidencia de las pruebas y del riesgo residual. Con ese riesgo medido, pasá a combinar las técnicas según cada uso.
No uses una sola técnica para todo. Ajustá la exposición de los datos y su utilidad según la tarea: usá enmascarado en pantallas de trabajo; seudonimización y tokenización para cruzar clientes, pedidos, chats y campañas; y agregación y generalización para informes y segmentos.
Combiná estas técnicas y conservá solo los campos y el nivel de precisión que necesitás, durante el tiempo necesario. Evitá segmentos demasiado pequeños.
Revisá los riesgos antes de avanzar, no al final. Comprobá si las transformaciones pueden revertirse y si los datos permiten identificar a alguien antes de compartirlos, unir nuevas bases, sumar integraciones o ampliar permisos. Si aún podés vincular un registro con una persona, tratá ese registro como dato personal, no como dato anónimo.
Primero, auditá los flujos de datos personales: identificá qué información manejás y clasificá cada API o punto de contacto según su nivel de riesgo. Priorizá los datos sensibles y los que expongan información de clientes y transacciones.
Elegí el método según lo que necesitás: usá hashing para verificar la integridad sin recuperar el dato original, o cifrado si necesitás recuperarlo. Aplicá privacidad desde el diseño e integrá la anonimización en la arquitectura de tus procesos desde el inicio.
Auditá cómo circula la información en tu tienda. Identificá las tablas y los campos que contienen identificadores directos, como nombres, correos y documentos, e indirectos, como direcciones IP, notas de pedidos y metadatos. Simulá el acceso de intrusos para comprobar si pueden cruzar esos datos e identificar a alguien.
Los datos seudonimizados siguen siendo datos personales si permiten identificar a una persona al combinarlos con otra información. Guardá las claves de reidentificación por separado, limitá el acceso de terceros y revisá los chats y registros cada tres meses.
Automatizá la eliminación de datos para garantizar la precisión y el cumplimiento legal. Incluí todos los servicios integrados, como los de análisis o marketing.
Si el proceso requiere supervisión, usá el Modo Supervisado: el sistema propone las acciones y vos aprobás la baja, teniendo en cuenta obligaciones como la retención de registros fiscales. Avisales a los terceros que recibieron la información para que también la eliminen. Conservá un registro de auditoría detallado durante al menos 24 meses.