Para reducir el fraude sin perder compras legítimas, empezaría con regresión logística y mediría el costo de cada decisión. Si el 99,5 % de las operaciones son legítimas, aprobar todo logra un 99,5 % de exactitud, pero no detecta ningún fraude. Por eso, compararía pérdidas, falsos rechazos y tiempos de respuesta, no solo aciertos.
En esta guía comparo siete enfoques según los datos que necesitan, su demora, mantenimiento y facilidad para explicar el resultado:
Comparación rápida
| Enfoque | Cuándo lo probaría | Qué controlaría |
|---|---|---|
| Regresión logística | Como referencia inicial | Calibración e interacciones |
| Árbol de decisión | Si necesito reglas auditables | Sobreajuste |
| Random forest | Si un árbol resulta inestable | Memoria y latencia |
| Gradient boosting | Con datos tabulares y fraude confirmado | Ajuste y cambios de patrones |
| Redes neuronales | Con grandes historiales o secuencias | Datos, cómputo y explicación |
| Anomalías | Con pocas etiquetas o ataques nuevos | Alertas sobre compras legítimas |
| Ensambles | Si los modelos detectan fraudes distintos | Costo y demora total |
Antes de automatizar rechazos, validaría con datos posteriores al entrenamiento y resultados ya confirmados. También mediría la latencia p95 y p99 de todo el checkout y separaría <u>aprobar, verificar, revisar y rechazar</u>: el objetivo no es marcar más compras, sino reducir pérdidas sin frenar ventas legítimas.
Antes de comparar modelos, definí estas condiciones mínimas de operación.
Usá un score calibrado y una capa de decisión que combine ese puntaje con reglas comerciales, la respuesta del proveedor de pagos, el contexto del cliente y la capacidad operativa. Esa capa debe permitir aprobar, pedir una verificación adicional, enviar a revisión manual o rechazar. Así podés ajustar los umbrales según el costo del fraude y de los falsos rechazos, sin reentrenar el modelo.
Definí un presupuesto de latencia de punta a punta, alineado con el flujo de autorización. Distribuí ese tiempo entre ingesta, consulta y preparación de atributos, inferencia, reglas y decisión. Precalculá o guardá en caché los atributos frecuentes para consultarlos con baja latencia. Medí cada etapa en p50, p95 y p99, no solo con el promedio. Si una dependencia supera el tiempo de espera, aplicá una alternativa prevista: una falla técnica no debería convertirse automáticamente en un rechazo.
Usá únicamente datos disponibles al momento de decidir y guardá su fecha de cálculo. La frecuencia transaccional indica cuántas actividades registra una entidad - tarjeta, cuenta, IP o dispositivo - dentro de una ventana definida. Documentá las ventanas de 5 minutos, 1 hora y 24 horas, y usá el mismo cálculo en entrenamiento y producción. Excluí contracargos y reclamos posteriores, además de cualquier agregado que incluya operaciones todavía desconocidas.
Separá fraude confirmado, contracargos, cancelaciones, disputas y casos abiertos para ajustar los umbrales y medir el impacto real. Registrá cuándo se conoció cada resultado y definí una ventana de maduración según las demoras reales de tu operación. Guardá también la versión del modelo, el score y la decisión original para vincularlos después con el resultado confirmado.
Validá en orden cronológico: entrená con un período anterior, ajustá con uno posterior y reservá el más reciente, con etiquetas ya maduras, para la prueba. Evitá duplicados y solapamientos entre transacciones relacionadas que permitan memorizar resultados. Incluir clientes recurrentes puede ser válido si refleja lo que ocurre en producción, pero medí por separado clientes nuevos y recurrentes, y dispositivos conocidos y nuevos. Reconstruí los atributos con la misma lógica en entrenamiento y producción, y compará los modelos por precisión, latencia y costo operativo.
La regresión logística sirve como modelo de referencia (baseline): estima la probabilidad de fraude mediante una suma ponderada de variables y permite comparar modelos más flexibles. Necesitás etiquetas confiables y suficientes casos de fraude confirmados. Podés incluir el importe, la antigüedad de la cuenta y los intentos de pago. Si las clases están desbalanceadas, usá class_weight="balanced" y evaluá el resultado con la tasa real de fraude.
El costo de inferencia es bajo, al igual que el de mantenimiento. Pero eso no impide que los patrones aprendidos queden desactualizados. Revisá si hace falta recalibrar el modelo cuando cambien las promociones, los medios de pago o los canales de adquisición.
Los coeficientes muestran qué variables aumentan o reducen el riesgo estimado. Comprobá la calibración con datos recientes, usando curvas de confiabilidad y el score de Brier. Hacelo especialmente después de aplicar pesos de clase o muestreo.
Funciona mejor con señales lineales que se pueden sumar. Para representar relaciones no lineales, necesitás transformaciones o interacciones explícitas.
No uses 0,50 como umbral por defecto. Elegí los puntos de corte según las pérdidas por fraude, el margen perdido y el costo de revisión. Si el fraude depende de interacciones no lineales, pasá a árboles de decisión.
Cuando el riesgo no es lineal, un árbol de decisión permite detectar combinaciones de señales que una regresión no separa bien.
Un árbol separa transacciones mediante reglas sobre monto, dispositivo, ubicación, velocidad de intentos e historial del cliente. En e-commerce, convierte esas señales del checkout en reglas que se pueden auditar.
Usá solo datos disponibles al autorizar la operación. El contracargo posterior sirve como etiqueta, no como entrada del modelo. Y no confundas un rechazo automático con fraude: no todos lo son.
Para decidir, el árbol recorre una sola ruta. El costo real suele estar en consultar el historial y los eventos recientes.
Limitá la profundidad, exigí un mínimo de observaciones por hoja y podá las ramas innecesarias. Estos controles importan porque pequeños cambios en los datos pueden modificar una división clave.
Guardá la ruta, las entradas, la versión y la decisión para poder explicar cómo se evaluó el riesgo. La tasa de fraude de una hoja no equivale a una probabilidad calibrada: revisala con datos recientes, sobre todo si esa hoja tiene pocas operaciones y sus resultados son inestables.
El árbol detecta combinaciones claras, pero puede pasar por alto ataques distribuidos o señales débiles. Derivá los casos ambiguos a revisión.
En Hot Sale y CyberMonday, medí por separado los resultados de clientes nuevos y recurrentes. Si cambian los patrones, probá una versión reentrenada en modo sombra antes de reemplazar la vigente.
Usalos cuando necesites reglas rápidas, auditables y fáciles de ajustar. Si buscás más estabilidad sin perder velocidad, el siguiente paso es un modelo de bosque.
Si un árbol simple no alcanza, Random Forest reduce la varianza y mejora la estabilidad sin perder la capacidad de modelar relaciones no lineales. Usalo para evaluar fraude en tiempo real en el checkout cuando necesitás más estabilidad que con un solo árbol.
Random Forest combina árboles entrenados con muestras y subconjuntos de variables aleatorios para detectar relaciones no lineales e interacciones. Podés usar datos de importe, dispositivo, método de pago e historial, con las variables categóricas codificadas.
Entrená con etiquetas confirmadas y validá con una ventana temporal posterior. Esa mayor estabilidad tiene un costo: más cómputo en producción.
Cuantos más árboles y mayor profundidad, más memoria y tiempo de respuesta necesitás. Medí p95 y p99 de inferencia por separado del tiempo de consulta de datos. Ajustá la cantidad de árboles y su profundidad al presupuesto de latencia del checkout.
Reentrená cuando cambien los patrones o maduren nuevas etiquetas. Además de responder a tiempo, el modelo debe permitir explicar y calibrar el score.
La importancia global de las variables no explica por qué se rechazó una compra puntual. Para eso, necesitás explicaciones locales y calibración explícita.
Calibrá el score con Platt scaling o regresión isotónica sobre un conjunto temporal separado. Después, verificá el resultado con curvas de calibración y el score de Brier. El buen desempeño ante señales conocidas no garantiza que el modelo detecte patrones nuevos.
El bosque detecta combinaciones conocidas con más estabilidad que un árbol individual, pero puede dejar pasar fraude nuevo sin historial etiquetado.
No uses el importe como única regla: combiná el historial de compras aprobadas previas con autenticación adicional o revisión. Para evaluar si podés mejorar la detección de esas combinaciones, comparalo con gradient boosting.
Cuando un bosque deja de separar bien casos parecidos, gradient boosting puede mejorar el ranking de riesgo: entrena árboles en secuencia para corregir errores paso a paso. Permite priorizar transacciones a partir de datos estructurados de compras, cuentas y dispositivos. Modelos como XGBoost o LightGBM generan un score que ayuda a ajustar los umbrales de aprobación, revisión manual o rechazo. La regularización limita la complejidad y reduce el sobreajuste.
Incorporá la antigüedad de la cuenta, los intentos recientes y las diferencias entre facturación y entrega. Un pago denegado no equivale a fraude confirmado. Separá los casos pendientes y tené en cuenta que los contracargos pueden llegar 30, 60 o 90 días después. No uses variables calculadas con información futura ni etiquetas que todavía no hayan madurado.
Precalculá los datos de ventanas cortas para evitar consultas adicionales durante el checkout:
Por ejemplo, los intentos de los últimos 10 minutos.
Para controlar el sobreajuste, limitá la profundidad de los árboles y ajustá la tasa de aprendizaje, la regularización L1/L2 y el early stopping. Monitoreá los cambios en dispositivos, medios de pago y scores. Si baja el rendimiento, reentrená el modelo y validalo con una ventana temporal posterior antes de ponerlo en producción.
Explicá el score con SHAP o importancias locales, sin confundir asociación con causa. El score no representa automáticamente una probabilidad. Calibralo por país, medio de pago y segmento, y verificá esa calibración por bandas de score.
Gradient boosting funciona bien con patrones repetidos:
Pruebas automatizadas de tarjetas o abuso de promociones.
Le cuesta más detectar ataques nuevos o cuentas legítimas tomadas. Evaluá precisión, recall y F1-score, pero elegí el umbral según el costo esperado: fraude no detectado, contracargos, revisión manual y margen perdido por falsos rechazos.
No uses 0,5 como umbral por defecto. Definí umbrales para decidir qué casos requieren autenticación adicional o revisión, y comprobá cómo afectan a clientes nuevos y recurrentes.
Si necesitás modelar relaciones más complejas o que dependan del contexto, pasá a redes neuronales.
Usá redes neuronales cuando gradient boosting no alcance para captar relaciones no lineales o secuencias del fraude transaccional y tengas suficientes datos para entrenarlas. Una MLP tabular trabaja con datos estructurados; una LSTM o un Transformer analiza el orden y el tiempo de los eventos; y las redes de grafos conectan cuentas, tarjetas y dispositivos para detectar ataques coordinados. Si faltan etiquetas confiables o el patrón cambia rápido, el siguiente paso es detectar anomalías.
Necesitás un historial de operaciones que cubra temporadas, medios de pago y perfiles de clientes. Si hay pocos casos de fraude confirmado, una red puede rendir menos que un modelo simple. Conservá el desbalance real al evaluar: la proporción de fraude debe reflejar la que enfrenta el sistema. Los cambios en el pipeline de variables también pueden afectar la estabilidad de la red.
Tomá 100 ms como techo orientativo, no como garantía. Una MLP liviana puede funcionar en CPU, pero medí la latencia p95 y los costos de inferencia. Las redes grandes suelen necesitar caché, variables precalculadas y más recursos de cómputo, incluida GPU. El costo total también debe incluir el entrenamiento, el servicio y el reentrenamiento.
Las explicaciones son aproximadas. Guardá las entradas y la versión del modelo para poder auditar sus decisiones. Antes de automatizarlas, calibrá el modelo y verificá con datos recientes que el riesgo estimado se corresponda con el fraude observado.
Las redes secuenciales y de grafos pueden detectar cambios de conducta y ataques coordinados, pero también penalizar compras legítimas poco habituales. Probá la red en modo sombra, sin que intervenga en las decisiones, y comparala con el modelo base durante el mismo período de evaluación.
Medí AUPRC, aprobación legítima, contracargos, costo operativo y demora. Una arquitectura más compleja no garantiza una mejora que compense los falsos rechazos. Cuando faltan etiquetas confiables, el foco pasa a los modelos de anomalías.
Cuando faltan etiquetas maduras o aparece un tipo de fraude nuevo, los modelos de anomalías permiten detectar señales tempranas en tiempo real. Isolation Forest es un buen punto de partida para datos tabulares. One-Class SVM necesita una base mayormente legítima y variables estandarizadas. Los autoencoders captan relaciones complejas, pero requieren más datos y monitoreo.
Entrená con importe, antigüedad de la cuenta, dispositivo y tasa de intentos. Segmentá por categoría, medio de pago y temporada: la inflación o una promoción pueden cambiar los montos sin que haya fraude. Para evaluar las alertas, usá contracargos confirmados, revisiones manuales y resultados de verificación únicamente cuando sean etiquetas maduras.
Precalculá la tasa de intentos por tarjeta, dispositivo y cuenta en ventanas de 10 minutos, 1 hora y 24 horas. Así evitás consultar todo el historial durante el checkout.
Isolation Forest suele requerir pocos recursos; los autoencoders demandan más procesamiento. Revisá las distribuciones de puntajes después de las promociones y ajustá las referencias solo cuando confirmes que el cambio es legítimo.
Un puntaje de anomalía no es una probabilidad de fraude. Mostrá qué señales activaron la alerta y calibrá los umbrales con una ventana temporal separada.
Según tu capacidad de revisión, evaluá el 0,5 %, 1 % o 2 % de las operaciones más anómalas. Medí la precisión y el valor del fraude detectado, no solo la cantidad de alertas.
Estos modelos detectan tasas inusuales de intentos, reutilización inusual de dispositivos o direcciones y pruebas coordinadas de tarjetas robadas. Pero pueden fallar si el ataque imita compras normales o si el fraude ya quedó incorporado a los datos de entrenamiento.
Medí también la conversión y las ventas legítimas interrumpidas: detectar rareza no demuestra intención fraudulenta.
Usá las alertas para verificar operaciones, enviarlas a revisión o alimentar un clasificador supervisado; no para rechazarlas automáticamente. Si necesitás combinar estas alertas con un score supervisado, pasá a ensambles de modelos.
Para combinar un score supervisado con señales de anomalía, usá un ensamble y aplicá reglas de negocio sobre el resultado. La idea es combinar modelos distintos: no confundas este enfoque con random forest o gradient boosting. La votación elige la clase mayoritaria; el promedio ponderado combina scores; el blending combina predicciones mediante una regla fija; y el stacking entrena un metamodelo con salidas fuera de muestra.
La ventaja es sumar coberturas distintas. La contrapartida es tener que coordinar datos y versiones.
El ensamble reutiliza los scores o las alertas de los modelos anteriores. Usá etiquetas maduras. En stacking, cada predicción que entrena al metamodelo debe provenir de un modelo que no haya visto esa operación ni datos futuros.
Medí los errores compartidos: si los modelos fallan en las mismas compras, combinarlos suma costo, no cobertura.
Coordinar varias inferencias agrega complejidad. Ejecutalas en paralelo y medí la latencia total del checkout, incluidas las consultas y la combinación de resultados. Definí qué hacer si un modelo no responde: usar un score de respaldo, pedir una verificación adicional o enviar la operación a revisión. Guardá, por cada operación, las versiones, los puntajes individuales y la decisión final.
No alcanza con decidir rápido: también tenés que poder explicar el aporte de cada modelo.
Calibrá cada salida antes de combinarla. Mostrá al revisor cuánto aportó cada modelo y guardá sus predicciones. En stacking, perdés trazabilidad del metamodelo si no conservás ese detalle.
Permití cambios manuales de decisión - overrides - con motivo obligatorio. Registrá usuario, fecha, hora, evidencia y decisión original. Cada excepción debe tener vencimiento y revisión periódica.
Definí umbrales explícitos para aprobar, pedir verificación, retener o rechazar. Elegilos según los contracargos, el margen, el costo de revisión y las ventas legítimas perdidas, no por la precisión global.
Probá primero en modo sombra, sin modificar decisiones, y compará los resultados con el mejor modelo individual usando etiquetas maduras. Pasá a una prueba controlada, con posibilidad de volver atrás, solo si la cobertura adicional justifica la latencia, el mantenimiento y los falsos rechazos. Si la mejora aparece únicamente en pedidos de alto riesgo, limitá el ensamble a ese segmento.
Para esa comparación, medí la latencia, la cobertura y el costo operativo tanto del ensamble como del mejor modelo individual.
La elección entre estos siete modelos depende de la latencia, los datos disponibles y el costo de equivocarse.
| Tipo de modelo | Mejor caso de uso | Fortaleza principal | Limitación principal | Complejidad de mantenimiento | Aptitud para puntaje en tiempo real |
|---|---|---|---|---|---|
| Regresión logística | Tiendas que necesitan una base explicable | Bajo costo y pesos interpretables | Requiere variables que representen las interacciones | Baja | Alta, con variables estables |
| Árbol de decisión | Prototipos y decisiones auditables | Reglas claras | Riesgo de sobreajuste e inestabilidad | Media | Alta, con un árbol pequeño y variables disponibles |
| Random forest | Datos tabulares de clientes, dispositivos y pagos | Mayor estabilidad que un solo árbol | Consume más memoria y resulta menos interpretable | Media | Alta, con cantidad y profundidad de árboles acotadas |
| Gradient boosting | Fraude supervisado, con contracargos o casos confirmados como etiquetas | Detecta relaciones no lineales en datos estructurados | Requiere más ajuste, calibración y control de deriva | Media-alta | Alta, con un modelo compacto y sin consultas remotas costosas |
| Redes neuronales | Grandes historiales, secuencias de navegación y señales complejas | Aprenden patrones temporales y no lineales | Necesitan más datos, infraestructura y esfuerzo para explicar sus decisiones | Alta | Media-alta, según el tamaño, el hardware y el servicio de inferencia |
| Detección de anomalías | Patrones nuevos o pocas etiquetas de fraude confirmado | Detecta desvíos del comportamiento habitual | Puede confundir compras legítimas inusuales con fraude | Media-alta | Media-alta, si las referencias de comportamiento están precalculadas |
| Ensambles entre modelos | Casos ambiguos que requieren señales complementarias | Cubre distintos patrones al combinar modelos | Suma componentes, costo operativo y dificultad de diagnóstico | Alta | Media-alta, con evaluación por etapas y carga controlada |
La aptitud es orientativa, no una garantía. El rendimiento depende del tamaño del modelo, la cantidad de variables y su actualización, la latencia del repositorio de variables y de la red, la capacidad de CPU o GPU y los picos de tráfico.
Durante la autorización del checkout, medí tanto la inferencia como el tiempo de la decisión completa. Precalculá las variables históricas y los contadores para evitar hacer esos cálculos durante la compra.
Para elegir según el tamaño y la madurez de tu operación, compará los modelos bajo las mismas condiciones: período de prueba, variables disponibles al momento de la compra y volumen de transacciones. Medí p50, p95 y p99, transacciones por segundo, tasa de tiempos de espera agotados, tasa de aprobación, recall de fraude y falsos rechazos. El promedio de latencia puede ocultar los picos.
Elegí según lo que hoy limita tu operación, no por la complejidad del modelo. Esta matriz lleva la comparación de fortalezas y límites a una decisión concreta para tu tienda.
| Restricción de la tienda | Enfoque candidato | Qué validar |
|---|---|---|
| Pocas etiquetas maduras | Detección de anomalías; sumar regresión logística cuando haya suficientes etiquetas confiables | Tasa de alertas confirmadas y validación temporal con etiquetas maduras |
| Latencia muy baja | Regresión logística o árboles poco profundos | p95/p99, timeouts y disponibilidad de variables de entrada bajo carga |
| Falsos rechazos costosos | Score calibrado y umbrales por costo, con verificación o revisión | Costo por pedido, ventas recuperadas y capacidad de revisión |
| Patrones de fraude nuevos | Detección de anomalías junto con un modelo supervisado | Fraude nuevo confirmado, deriva y tiempo de detección |
| Alto volumen de transacciones | El modelo más simple que cumpla el objetivo de riesgo | Capacidad sostenida, ráfagas, recuperación y consistencia de las decisiones |
| Requisitos estrictos de explicación | Regresión logística o árboles poco profundos, con motivos registrados | Fidelidad, utilidad para analistas y trazabilidad de variables, umbrales y versión |
Si tenés pocas etiquetas, una compra inusual es una señal para investigar, no una prueba de fraude.
Cuando perder una compra legítima sale caro, separá las decisiones de aprobar, verificar y rechazar. Ajustá los umbrales según el margen, los contracargos y el costo de revisión.
Antes de pasar a producción, probá con 3 a 5 veces el pico previsto. Incluí fallas y colas, y evaluá tanto la disponibilidad de las variables de entrada como la calidad de las decisiones bajo carga.
Antes de activar rechazos automáticos, corré el candidato en modo observación o con una fracción del tráfico. Segmentá los resultados por promociones y revisá cómo cambia el riesgo según el medio de pago, los clientes nuevos y recurrentes, las categorías y las cuotas.
Después de elegir el modelo, medí su impacto económico, no solo su score. La exactitud puede esconder un modelo que no detecta fraude: si el 99,5 % de las transacciones son legítimas, aprobarlas todas da un 99,5 % de exactitud sin detectar ningún fraude. Evaluá el modelo con datos de un período posterior al entrenamiento, la tasa de fraude de tu tienda y etiquetas confirmadas por contracargos o investigaciones. Antes de cerrar la evaluación, esperá a que maduren los contracargos y reclamos.
Definí TP como fraudes detectados; FP, operaciones legítimas marcadas; FN, fraudes no detectados; y TN, operaciones legítimas no marcadas. Con estos datos podés evaluar los umbrales para aprobar, verificar o rechazar durante el checkout:
Marcar no es rechazar. Una operación marcada puede aprobarse después de una verificación o revisión. La tasa de falsos positivos = FP/(TN+FP) mide las operaciones legítimas marcadas sobre el total de legítimas. En cambio, la tasa de falsos rechazos = pedidos legítimos rechazados / pedidos legítimos totales mide el resultado final. Registrá ambas por separado, junto con las aprobaciones, verificaciones y rechazos. Segmentá esos datos por canal, medio de pago, dispositivo, importe y cliente nuevo o recurrente.
Después, calculá el costo real de cada umbral. Para el fraude aprobado, usá la exposición económica - mercadería, envío, comisiones y contracargo - , no el importe facturado. Para los falsos rechazos, contá el margen perdido.
Estimá el costo esperado de cada umbral con esta fórmula, sin duplicar costos:
Fraude no detectado × pérdida por fraude + falsos rechazos × margen perdido + revisiones y verificaciones × su costo respectivo + margen perdido por abandono por fricción.
El mejor F1 no siempre es el más barato. Elegí el umbral que minimice ese costo sin superar tu capacidad diaria de revisión.
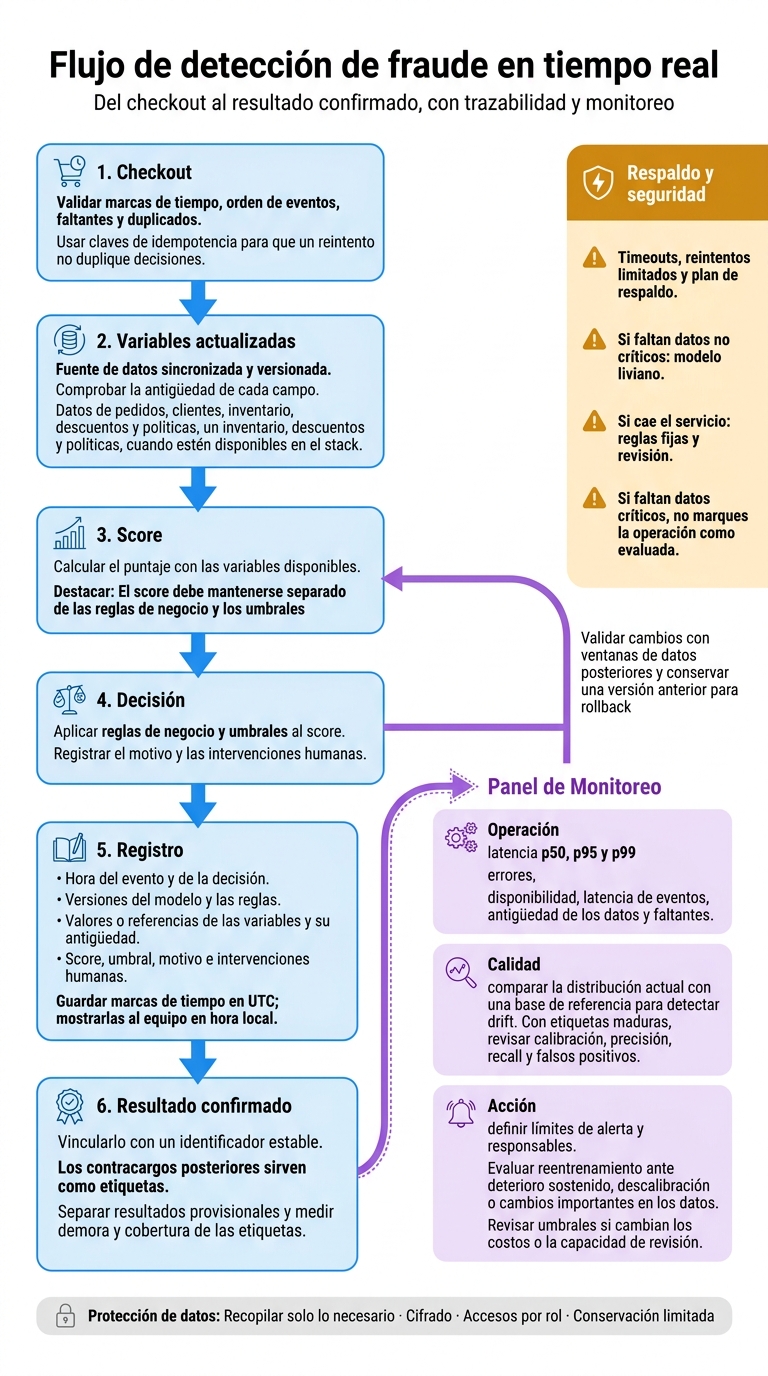
Flujo de detección de fraude en tiempo real
Después de elegir el modelo, conectalo al checkout y medí cómo funciona en producción. Armá un flujo que puedas auditar: checkout → variables actualizadas → score → decisión → registro → resultado confirmado. Validá las marcas de tiempo, el orden de los eventos, los faltantes y los duplicados. Usá claves de idempotencia para que un reintento no duplique decisiones. Los contracargos posteriores sirven como etiquetas.
Ese flujo necesita una fuente de datos sincronizada y versionada. Si tu stack ya sincroniza pedidos, clientes, inventario, descuentos y políticas con Burbuxa, usalo como capa de datos actualizados para calcular el score. Verificá la antigüedad de cada campo y protegé los datos: recopilá solo lo necesario, aplicá cifrado, asigná accesos por rol y limitá el tiempo de conservación.
Mantené el score del modelo separado de las reglas de negocio y los umbrales. Registrá la hora del evento y de la decisión, las versiones del modelo y las reglas, los valores o referencias de las variables y su antigüedad, el score, el umbral, el motivo y las intervenciones humanas. Guardá las marcas de tiempo en UTC y mostralas al equipo en hora local. Vinculá cada resultado confirmado con un identificador estable.
Con el flujo en marcha, medí la deriva de datos, la calidad de las etiquetas y el desempeño. Monitoreá latencia p50, p95 y p99, errores, disponibilidad, latencia de eventos, antigüedad de los datos y faltantes. Compará la distribución actual con una base de referencia para detectar drift. Cuando las etiquetas estén maduras, revisá calibración, precisión, recall y falsos positivos para decidir si ajustar umbrales o reentrenar. Separá los resultados provisionales y medí la demora y la cobertura de las etiquetas.
Definí de antemano qué hacer ante cada desvío, con límites de alerta y responsables. Ante un deterioro sostenido, descalibración o cambios importantes en los datos, evaluá el reentrenamiento. Si cambian los costos o la capacidad de revisión, revisá los umbrales. Validá los cambios con ventanas de datos posteriores y conservá una versión anterior para permitir un rollback. Establecé timeouts, reintentos limitados y un plan de respaldo: un modelo liviano si faltan datos no críticos; reglas fijas y revisión si cae el servicio. Si faltan datos críticos, no marques la operación como evaluada.
Con el costo ya medido, empezá con regresión logística como modelo de referencia. Sumá reglas de negocio solo para umbrales y excepciones, y usá esa base para comprobar si otro modelo aporta valor.
Después, compará árboles, random forest y gradient boosting con validación cronológica. Reservá el período más reciente para la prueba final: elegí el modelo y ajustá el umbral con la validación, no con la prueba.
Si el modelo supervisado no cubre patrones nuevos, sumá detección de anomalías como apoyo para verificar o revisar compras, no para rechazarlas automáticamente.
Por ejemplo, cambios bruscos de importe o patrones de cuotas inusuales.
Recién después evaluá un ensamble. Adoptalo solo si mejora el impacto económico total: más aprobaciones legítimas, menos pérdidas por fraude y contracargos, y latencia p95/p99 dentro del presupuesto. Mejorar el recall no alcanza si aumentan los falsos rechazos.
No necesitás una cantidad mínima predefinida de fraudes confirmados para empezar. Podés usar un enfoque híbrido: entrenar un modelo de detección de anomalías, como un autoencoder, solo con transacciones legítimas para detectar comportamientos fuera de lo habitual.
Después, el equipo humano revisa los casos sospechosos y confirma si se trata de fraude. Esos datos etiquetados se pueden sumar de a poco al entrenamiento para obtener modelos más precisos y con mejor capacidad de detección.
Evaluá los falsos rechazos con pruebas en modo sombra, sin bloquear a clientes reales. Usá pruebas A/B para comparar la conversión y los rechazos con tu línea base. Auditá tanto las órdenes bloqueadas como los casos enviados a revisión manual.
Si los rechazos aumentan pero los contracargos no bajan, es una señal de que estás perdiendo clientes legítimos. Registrá las revisiones para que el modelo aprenda de esos resultados y compará el ahorro por fraude evitado con las ventas perdidas.
Ajustá los umbrales dinámicos según la temporada y el historial. Un ataque suele dejar señales como ráfagas de intentos fallidos, cambios rápidos de tarjeta, dispositivos sospechosos o inconsistencias geográficas. En cambio, un pico de compras legítimas mantiene patrones de navegación naturales.
Combiná las señales de velocidad con el perfil del comprador, sin aplicar bloqueos rígidos. Si hay dudas, pedí una verificación adicional o una revisión humana. Antes de activar los controles, probá en modo sombra para evitar que los falsos positivos afecten las ventas.