Si yo pronostico demanda solo con ventas históricas, puedo equivocarme feo. Un stockout, un descuento del 15 %, una campaña paga o un feriado pueden mover la serie y tapar lo que la gente hubiera comprado de verdad.
En esta nota voy al punto: para prever mejor, yo necesito separar ventas observadas de demanda real, armar un dataset limpio y medir qué efecto tuvo cada palanca del negocio. Si no lo hago, puedo terminar comprando de menos, sobrestockeando o leyendo como “baja demanda” lo que en verdad fue “sin stock”.
La idea central es simple:
Un ejemplo lo muestra rápido: si yo tengo 20 unidades disponibles y recibo 180 visitas en una campaña, vender 20 no prueba que la demanda fue 20. Solo prueba que me quedé sin stock. Lo mismo pasa cuando un pico en Hot Sale adelanta compras y deforma la serie.
También resumo algo que suele pasarse por alto: sumar variables no vuelve causal a un modelo. Para hablar de causalidad, yo tengo que estimar cuánto cambió la demanda por una acción puntual - como precio, descuento o pauta - controlando estacionalidad, stock y otros factores al mismo tiempo.
fecha–SKU–canal–región| Tema | Si lo hago mal | Si lo hago bien |
|---|---|---|
| Ventas vs. demanda | Tomo ventas como verdad | Ajusto por stock y contexto |
| Promos y precio | Veo correlaciones sueltas | Mido efecto atribuible |
| Dataset | Mezclo ceros distintos | Distingo sin ventas, sin stock y canal cerrado |
| Validación | Parto muestras al azar | Uso backtesting cronológico |
| Éxito del modelo | Miro solo error | Miro error, servicio y margen |
En pocas palabras: yo no arranco por el modelo. Arranco por la pregunta de negocio, limpio la base, alineo las variables y recién después estimo efectos. Ese camino suele ordenar mejor compras, campañas y reposición.
Con la pregunta causal ya definida, el paso que sigue es poner orden en el dataset para que la serie muestre lo que pasa en el negocio y no simple ruido. Cómo armás el dataset condiciona todo lo demás.
Antes de sacar un solo dato, conviene responder tres preguntas bien concretas: qué querés pronosticar, con cuánta anticipación y con qué nivel de detalle.
El objetivo puede ser unidades vendidas, pedidos, ingresos en ARS o demanda ajustada por disponibilidad. Cada métrica sirve para una decisión distinta. Las unidades ayudan en reposición, los pedidos sirven para dimensionar logística, los ingresos ayudan en planificación financiera. La demanda ajustada por disponibilidad busca estimar cuánto se habría vendido sin quiebres de stock.
El horizonte tiene que calzar con la decisión de negocio: 1–6 semanas para reposición, 3–6 meses para compras y promos, y 6–18 meses para surtido y capacidad. La granularidad también tiene que seguir la acción. Por ejemplo, un pronóstico diario a nivel SKU–canal puede hacer falta para manejar inventario, mientras que uno semanal por categoría puede alcanzar para presupuesto.
Definí una clave estable: fecha–SKU–canal–región. Sumá provincia o centro de despacho solo si eso cambia la operación. También dejá asentado que las fechas van en DD/MM/AAAA, los precios en pesos, las cantidades en unidades y la temperatura en °C.
Hay un punto práctico que suele pegar fuerte: cuanto más desagregada está la serie, más ceros aparecen, más ruido entra y más chances hay de sufrir cambios de identificador. Por eso, conviene construir una fila por período aunque no haya ventas. Y no meter todo en la misma bolsa: no es lo mismo “cero ventas con stock disponible” que “sin stock”, “producto no publicado” o “canal cerrado”.
Con el objetivo y la granularidad ya claros, el dataset tiene que reflejar los factores que cambian la demanda. La regla acá es simple: elegí variables que expliquen movimiento, no solo las que tenés más a mano.
| Variable | Mecanismo esperado | Rezago probable | Riesgo principal |
|---|---|---|---|
| Precio de venta | Un precio menor puede aumentar conversión y unidades | Mismo día y días posteriores | Confundir precio con otro cambio simultáneo |
| Profundidad del descuento | Aumenta el atractivo de la oferta y puede adelantar compras | Inmediato, con posible caída posterior | Descuentos aplicados solo a productos ya esperados como exitosos |
| Inversión publicitaria | Incrementa tráfico, consideración y conversiones | De horas a varios días | Reportes tardíos y atribución duplicada |
| Disponibilidad de stock | El stock insuficiente reduce ventas observadas y puede generar sustitución | Inmediato | Tratar una venta baja como baja demanda |
| Temperatura y precipitaciones | Cambian la demanda por categoría y la sensibilidad a ciertas compras | Mismo día o 1–7 días | Usar una estación meteorológica que no representa al cliente |
| Feriados y fechas especiales | Cambian tráfico, horarios y composición de la demanda | Anticipación de días o semanas | No distinguir feriados nacionales, provinciales y locales |
| Fechas de cobro | Pueden concentrar compras cerca de salarios, jubilaciones o beneficios | 0 a varios días | Usar una fecha nacional para clientes con calendarios distintos |
| Lanzamientos y caídas o fallas del sitio | Generan demanda inicial o reducen conversión | Inmediato y primeras semanas | Confundir novedad o falla puntual con cambio permanente |
Cada variable debería quedar registrada con campos estructurados: fecha de inicio, fecha de fin e intensidad. En precio, por ejemplo, hace falta guardar precio de lista, precio efectivamente cobrado, descuento absoluto y porcentual, y vigencia. En Argentina, no alcanza con anotar “20 % OFF”. Hay que distinguir si el precio pasó de $ 45.000 a $ 36.000, si el descuento aplicó solo a cierto medio de pago, si hubo cuotas y si estuvo disponible en todos los canales.
Cada variable tiene que corresponder al momento en que estaba disponible para tomar la decisión, no al momento en que el dato quedó cerrado. Si usás datos que aparecieron después de la fecha de corte, generás fuga de información y una sensación falsa de que el modelo anda mejor de lo que en verdad anda.
El sesgo por quiebres de stock pide atención aparte. Como piso mínimo, el dataset debería incluir stock inicial, stock final, unidades disponibles, minutos sin stock y stockout_flag. Los períodos censurados pueden excluirse, ponderarse o imputarse, pero el criterio que elijas tiene que quedar documentado.
Antes de modelar, hacé una auditoría simple pero seria: duplicados, fechas fuera de rango, SKU discontinuados, cambios de código, zonas horarias y campañas cargadas con demora. Si la base queda mal alineada, el modelo termina explicando como negocio lo que en el fondo era puro ruido.
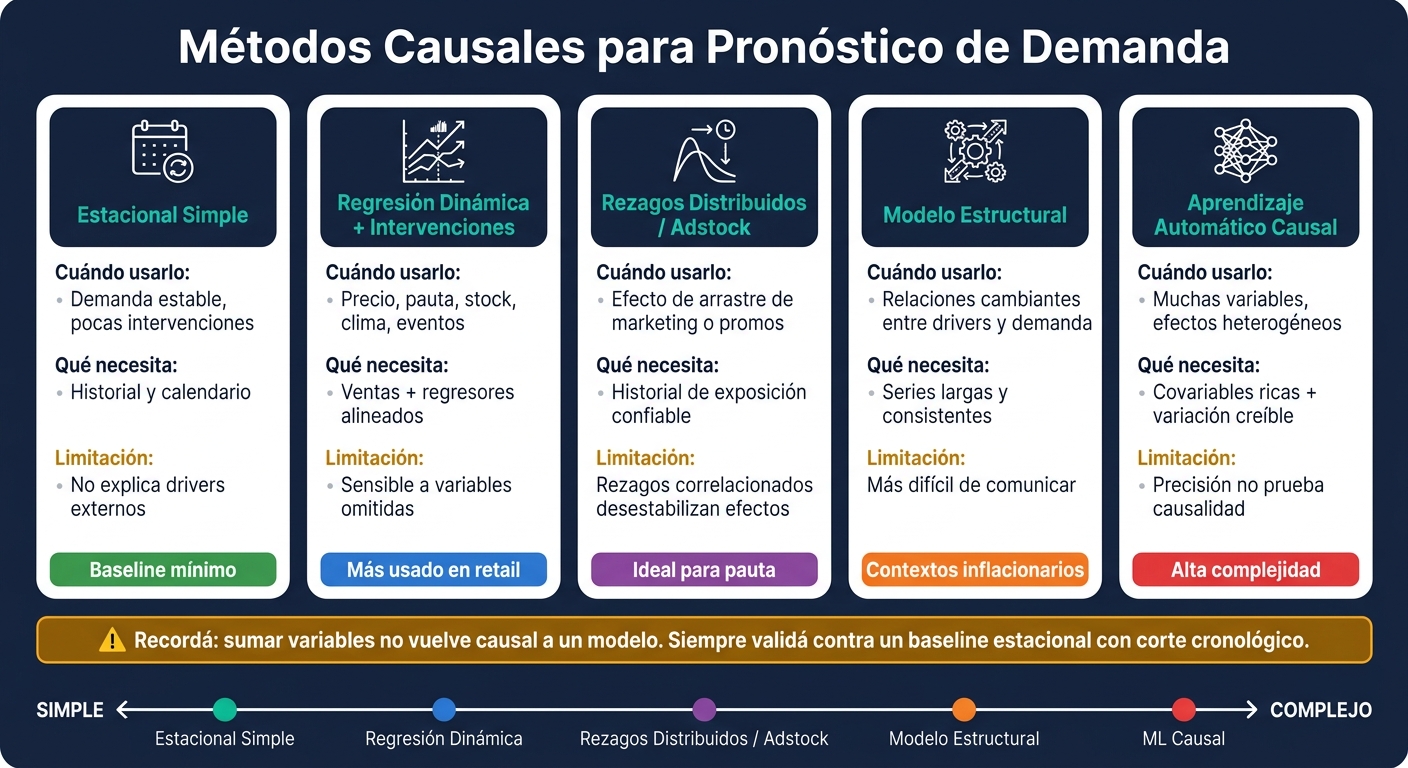
Métodos Causales para Pronóstico de Demanda en Ecommerce
Si ya alineaste fechas, stockouts y variables externas, recién ahí vale la pena elegir el método. La respuesta no pasa por usar el modelo más sofisticado, sino por la decisión que tenés que tomar y por los datos que de verdad tenés a mano.
La regresión dinámica mezcla componentes de series de tiempo - tendencia, estacionalidad y autocorrelación - con regresores externos alineados en el tiempo. La idea es simple: separar el efecto de precio, promo, clima y stock de la tendencia base. En retail, esto sirve mucho porque baja la confusión entre “vendí más por una promo” y “vendí más porque justo era sábado”.
Por ejemplo, un modelo diario puede incluir día de la semana, precio, descuento, pauta, stock, clima y feriados. Cada coeficiente se puede leer en clave de negocio, algo muy útil cuando hay que explicar resultados a Comercial, Marketing o Finanzas.
Cuando la pregunta gira alrededor de un evento puntual, conviene sumar un modelo de intervención. Acá importa mucho la forma del efecto: pulso para shocks de un solo momento, escalón para cambios que quedan, y decaimiento para efectos que se van apagando con el paso de los días.
Y si el impacto no aparece en el mismo período, no alcanza con una regresión simple. En ese caso, hay que pasar a rezagos distribuidos.
Cuando una variable mueve la demanda durante varios períodos, los rezagos distribuidos o las transformaciones adstock suelen ser la mejor herramienta. El caso clásico es la pauta publicitaria: una campaña puede traer clics en el momento y, además, compras de retorno varios días después. Un modelo de efecto rezagado estima por separado el impacto de la inversión en t, t-1, t-2 y t-7.
Los modelos estructurales de series de tiempo sirven cuando el vínculo entre un driver y la demanda cambia con el tiempo. Un ejemplo claro: la sensibilidad al precio puede moverse en contextos de inflación. Lo que valía hace seis meses tal vez hoy ya no explique igual el comportamiento de compra.
Por otro lado, el aprendizaje automático causal - métodos como double machine learning o causal forests - entra en juego cuando hay muchas variables y efectos distintos según SKU, canal o segmento. Ahora bien, hay un punto que no se puede pasar por alto: una alta precisión predictiva no prueba causalidad.
A veces, lo más simple gana. Si la demanda es bastante estable, hay pocas intervenciones y no tenés variables causales disponibles, un modelo estacional simple puede rendir mejor que uno más complejo en backtests reales. No suena glamoroso, pero pasa.
El seasonal naïve - que repite el mismo período del ciclo anterior - es el baseline mínimo que cualquier modelo más sofisticado debería superar antes de adoptarse.
La elección, en el fondo, se resume en tres cosas: estabilidad, tipo de intervención y necesidad de interpretar el resultado sin vueltas.
| Método | Cuándo usarlo | Qué necesita | Limitación principal |
|---|---|---|---|
| Estacional simple | Demanda estable, pocas intervenciones | Historial y calendario | No explica drivers externos |
| Regresión dinámica con intervenciones | Precio, pauta, stock, clima, eventos | Ventas + regresores alineados | Sensible a variables omitidas |
| Rezagos distribuidos / adstock | Efecto de arrastre de marketing o promos | Historial de exposición confiable | Rezagos correlacionados desestabilizan efectos |
| Modelo estructural | Relaciones cambiantes entre drivers y demanda | Series largas y consistentes | Más difícil de comunicar |
| Aprendizaje automático causal | Muchas variables, efectos heterogéneos | Covariables ricas + variación creíble | Precisión no prueba causalidad |
El siguiente paso es estimar el efecto real y validarlo contra un baseline.
Con el dataset listo y el método ya definido, toca una parte clave: medir si de verdad mejora el pronóstico y si la atribución causal se sostiene. No es lo mismo una cosa que la otra. Pronosticar demanda busca estimar cuánto se va a vender. Estimar causalidad, en cambio, intenta medir cuánto sumó una acción frente al escenario sin intervención.
Antes de correr cualquier modelo, conviene dejar la intervención cerrada con precisión. Eso incluye la profundidad del descuento, el precio final, qué SKU y qué canal quedaron afectados, la ventana de exposición y el período de comparación. También hay que controlar estacionalidad y otras variables que puedan mover la demanda.
Además, medí sustitución, adelanto de compras y margen neto. Si una campaña suma 300 unidades al producto promovido, pero al mismo tiempo le resta 80 a un artículo parecido y adelanta compras de la semana siguiente, no podés tomar esas 300 unidades como ganancia neta. Lo que importa es el incremento neto después de descontar sustitución, timing y costos del descuento.
Si querés evaluar si el modelo causal mejora el pronóstico, la validación tiene que ser cronológica. Entrenás con el período más antiguo, pronosticás el bloque siguiente, registrás los errores y movés la fecha de corte. Las particiones aleatorias no sirven para esto: meten información del futuro y tienden a inflar la precisión real.
Compará siempre contra tres referencias claras:
Si el modelo causal no le gana a la línea base estacional simple en backtests reales, sobre todo en semanas sin intervenciones, puede que no valga la pena cargar con más trabajo operativo. También conviene reportar resultados por separado para períodos promocionales y no promocionales, y para períodos con stock completo y períodos con restricción de inventario.
La validación no debería medir solo precisión. También tiene que mostrar si el modelo ayuda a tomar mejores decisiones. La métrica correcta depende de la decisión operativa que va a usar el equipo.
| Métrica | Pregunta operativa que responde | Períodos a evaluar por separado |
|---|---|---|
| MAE | ¿Cuántas unidades se desvía el pronóstico, en promedio? | Promo vs. no promo; SKUs de alto y bajo volumen |
| WAPE | ¿Cuál es el error relativo al total del portafolio? | Precio lleno vs. con descuento; categorías de distinto volumen |
| Sesgo (Bias) | ¿El modelo sobreestima o subestima sistemáticamente? | Períodos con stock completo vs. restringidos; tratados vs. no tratados |
| Cobertura del intervalo de predicción | ¿Los resultados observados caen dentro del rango declarado? | Semanas normales, de campaña y períodos volátiles |
| Nivel de servicio | ¿El pronóstico permite cumplir la demanda sin quiebres? | Ventanas de reposición y SKUs críticos |
| Ingresos y margen de contribución | ¿El pronóstico mejora resultados financieros, no solo estadísticos? | Promo vs. no promo; productos con distinto margen |
| Error de efecto incremental | ¿El efecto estimado de la acción se acerca al observado en un grupo de control? | Por tipo de campaña automatizada, banda de descuento y mercado |
Un pronóstico puede mostrar buen MAE y, aun así, generar quiebres que sean inaceptables en productos de alto margen. Ahí está el punto: las métricas estadísticas y las métricas de negocio no compiten entre sí. Hay que leerlas juntas. Esa lectura después ordena compras, pricing y reposición.
Con el modelo ya validado, el paso que sigue es hacerlo funcionar de manera repetible. El pronóstico causal sirve de verdad cuando deja de ser un análisis aislado y pasa a formar parte de un ciclo operativo. Semana a semana, el equipo actualiza el forecast y lo convierte en decisiones concretas.
Conviene trabajar con dos ritmos. La revisión semanal se enfoca en reposición, campañas activas y ajustes de inventario. La revisión mensual o trimestral mira algo más de fondo: la estructura del modelo, los efectos causales estimados y los supuestos de mediano plazo.
Acá la meta es simple: llevar el modelo a tareas, responsables y controles claros.
| Etapa del flujo | Datos necesarios | Equipo responsable | Resultado | Control |
|---|---|---|---|---|
| Definir alcance | Jerarquía de SKU, canales, horizonte, decisiones de planificación | Supply planning y equipo comercial | Variable objetivo y calendario de pronóstico | Confirmar que la granularidad coincide con la decisión |
| Preparar historial de demanda | Pedidos, devoluciones, cancelaciones, disponibilidad de stock, estado del producto | Datos y operaciones | Serie de demanda limpia con flags de quiebre de stock | Reconciliar unidades e ingresos con los sistemas fuente |
| Agregar variables causales | Drivers validados y alineados en el tiempo | Marketing, pricing, operaciones, datos | Set de features alineado en el tiempo | Verificar que cada variable era conocida al momento de generar el pronóstico |
| Calibrar benchmark estacional | Historial de demanda y benchmark estacional | Equipo de datos o pronósticos | Pronóstico base | Comparar con benchmarks naïve y estacionales |
| Ajustar modelo causal | Benchmark más drivers causales | Equipo de datos o pronósticos | Pronóstico, intervalos y efectos estimados | Verificar estabilidad de coeficientes y dirección plausible |
| Planificar acciones | Pronóstico por SKU, canal, ubicación y horizonte | Supply, merchandising y marketing | Órdenes de compra, asignación, campañas y recomendaciones de dotación | Simular consecuencias de quiebre, exceso de inventario y nivel de servicio |
| Revisar desempeño | Demanda real, disponibilidad, ejecución de campañas, versiones del pronóstico | Equipo de planificación interfuncional | Reporte de error, sesgo, uplift y excepciones | Error, sesgo, uplift y desvíos |
| Re-estimar | Nuevas observaciones y cambios en condiciones del negocio | Datos y gobernanza | Parámetros actualizados y cambios documentados | Confirmar que el nuevo modelo mejora respecto al base |
La lógica de fondo importa mucho: cada salida tiene un dueño, cada input tiene una fuente y cada decisión pasa por una validación. Así, el modelo deja de ser un dashboard suelto y pasa a meterse en la operación diaria.
Con este circuito armado, una capa compartida de datos ayuda a ejecutar más rápido. Burbuxa centraliza productos, pedidos, clientes, inventario, descuentos y campañas para sacar features y correr el flujo sin reconciliaciones manuales.
Ahora bien, integrar datos no prueba causalidad. El equipo igual tiene que definir el tratamiento con precisión, alinear bien los tiempos, fijar una lógica de comparación que se sostenga y seguir de cerca el modelo después del lanzamiento. La capa integrada sirve para una extracción consistente de features y para la ejecución operativa. El modelado y la validación, en cambio, conviene llevarlos por un carril aparte, con supuestos documentados y comparación del pronóstico causal contra baselines transparentes.
Si el flujo está funcionando, la complejidad extra solo se justifica cuando mejora decisiones y nivel de servicio. Los modelos más complejos - como los de efectos rezagados o causal machine learning - tienen que ganarse ese lugar mostrando mejoras repetibles en decisiones y resultados, no solo por sofisticación técnica. Un pronóstico que mejora el WAPE pero no baja los quiebres de stock ni ordena mejor las compras, en los hechos, no está cumpliendo su trabajo.
Planificá con históricos, drivers validados y decisiones trazables. Empezá por el ciclo mínimo: target, stock, drivers, validación y responsables.
Cuando hay un quiebre de stock, las ventas históricas ya no muestran la demanda real. Se cortan por falta de producto, no porque la gente haya dejado de buscarlo.
Para estimar esa demanda, la IA mira señales externas y patrones de productos parecidos. Por ejemplo:
Con esos datos, puede inferir cuánto se habría vendido si el producto hubiera estado disponible.
Primero, sumá variables causales ligadas de forma directa a la demanda y con buena cobertura y calidad. Ahí entran las ventas históricas, el comportamiento en el sitio y las promociones o campañas.
Después, agregá variables externas con alto poder explicativo, como el clima, la estacionalidad y los eventos. Y, al final, incorporá precio, stock e inventario para no confundir la demanda con un problema de disponibilidad.
Alcanza cuando operás en entornos estables, con patrones históricos de ventas claros y previsibles. Suele funcionar bien con pocos datos y una demanda sin cambios raros o fuera de lo común.
Si el mercado es volátil o lanzás productos nuevos, por lo general hace falta ajustar a mano. En esos casos, conviene sumar variables causales, como el clima, eventos locales o la pauta.