Para medir la latencia de API, registro cuánto tarda cada endpoint en milisegundos y reviso p50, p95 y p99 junto con errores y timeouts. No me quedo con el promedio: el p99 muestra el tiempo que no supera el 99 % de las solicitudes y me ayuda a detectar demoras que afectan a pocas compras.
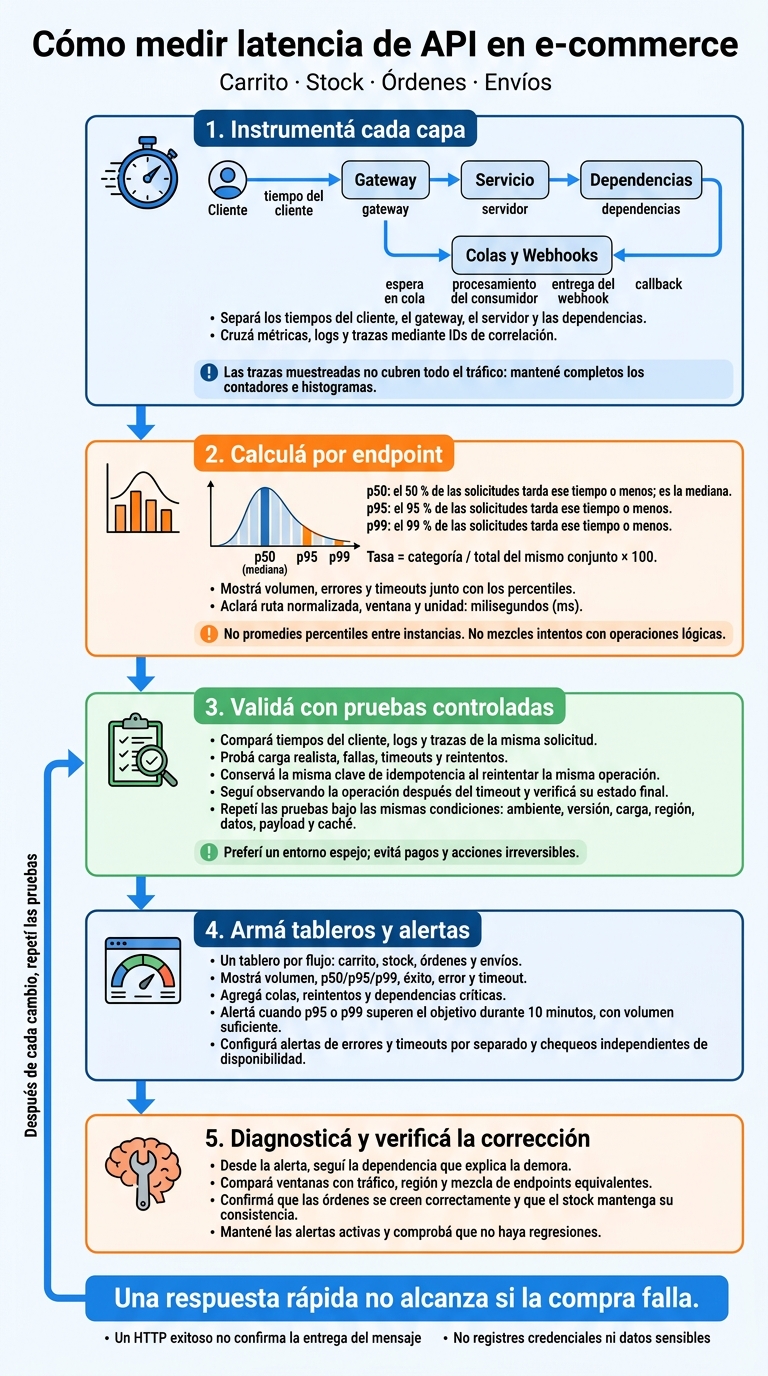
En carrito, stock, órdenes y envíos, sigo este esquema:
Mi criterio es simple: <u>una respuesta rápida no alcanza si la compra falla</u>. Por eso, después de cada cambio, comparo tiempos y resultados bajo las mismas condiciones y compruebo que las órdenes, el stock y las entregas queden en el estado esperado.
Cómo medir latencia de API en e-commerce
Una vez priorizados los endpoints, medí cada capa para relacionar duración, errores y timeouts en carrito, stock, órdenes y envíos.
Instrumentá el gateway y el middleware de aplicación con un temporizador monotónico. Inicialo cuando llegue la solicitud y detenelo cuando responda, falle, se cancele o venza el timeout. gateway_duration_ms y server_duration_ms miden capas distintas; ninguno mide el tiempo del cliente.
Emití histogramas de duración y contadores de resultados independientes de las trazas. Así podés calcular p95, p99, tasa de error y tasa de timeout por endpoint.
En los logs JSON, guardá la marca temporal UTC, servicio, versión, método, plantilla de ruta, código HTTP cuando exista, duration_ms, ambiente, región, request_id, trace_id, span_id, timeout y error_type normalizado.
Si no hubo respuesta HTTP, registrá la cancelación o el fallo: no inventes un código. Al exportar, excluí tokens, credenciales, datos de pago y cuerpos completos de pedidos.
Propagá W3C Trace Context mediante traceparent entre el gateway, los servicios y las llamadas HTTP. Creá spans para las consultas a la base de datos y las operaciones de carrito, reserva de stock, creación de órdenes y cotización de envíos.
En las colas, transportá el contexto en los encabezados del mensaje. Para webhooks asíncronos, conservá ese contexto o vinculá explícitamente la nueva traza con la original. Verificá que se propague: algunos intermediarios rompen el contexto.
Medí por separado la espera en cola, el procesamiento del consumidor, la entrega del webhook y el callback. Registrá cada intento, reintento, dependencia y timeout.
Si el gateway corta la espera y la reserva de stock sigue, el timeout pertenece al gateway; el resto necesita su propia duración y resultado.
Las trazas muestreadas no cubren todo el tráfico. Mantené completos los contadores e histogramas y usá tail sampling para priorizar errores, timeouts y solicitudes lentas. Definí retenciones separadas según el volumen, el costo y las necesidades de investigación.
Usá métricas, logs y trazas en conjunto para recolectar y cruzar estas señales:
| Señal | Propósito | Herramientas | Uso práctico |
|---|---|---|---|
| Métricas | Medir volumen, duraciones y resultados | OpenTelemetry Metrics y Prometheus | Calcular p95/p99 por endpoint |
| Logs | Registrar contexto de fallos y reintentos | OpenTelemetry Logs y Loki | Investigar una solicitud mediante sus IDs |
| Trazas | Desglosar dependencias y trabajo asíncrono | OpenTelemetry Tracing y Tempo | Localizar demoras en stock, órdenes o envíos |
| Alertas | Avisar sobre deterioros sostenidos | Prometheus y Grafana Alerting | Detectar aumentos de errores o timeouts |
Para diagnosticar desvíos en los percentiles y las tasas por endpoint, consultá los logs y las trazas.
Con métricas, logs y trazas ya instrumentados, usá esas señales para calcular percentiles, errores y timeouts por endpoint.
Calculá cada percentil por ruta normalizada. Dejá explícitos la ventana, la unidad y el conjunto de datos.
| Métrica | Significado | Uso |
|---|---|---|
| p50 | El 50 % de las solicitudes tarda ese tiempo o menos; es la mediana | Ver la experiencia típica |
| p95 | El 95 % de las solicitudes tarda ese tiempo o menos | Detectar degradaciones que afectan a una minoría relevante |
| p99 | El 99 % de las solicitudes tarda ese tiempo o menos | Investigar la cola extrema y las solicitudes cercanas al límite de tiempo |
En Prometheus, esta consulta devuelve el p95 por ruta de los últimos 15 minutos, en milisegundos. Para obtener los otros percentiles, cambiá 0.95 por 0.50 o 0.99. Los nombres de métricas y etiquetas deben coincidir con tu instrumentación.
histogram_quantile(
  0.95,
  sum by (route, le) (
    rate(http_request_duration_seconds_bucket{
      service="checkout-api"
    }[15m])
  )
) * 1000
Estas consultas muestran el volumen estimado de observaciones y las solicitudes por segundo en esa misma ventana:
# Cantidad estimada de observaciones en 15 minutos
sum by (route) (
  increase(http_request_duration_seconds_count{
    service="checkout-api"
  }[15m])
)

# Throughput: solicitudes por segundo
sum by (route) (
  rate(http_request_duration_seconds_count{
    service="checkout-api"
  }[15m])
)
Para interpretar los resultados, tené en cuenta el volumen y cómo agrupás los buckets:
le. No promedies percentiles entre instancias.+Inf y ajustá la ventana al volumen. Si hay poco tráfico, mostrá siempre el volumen.Calculá cada tasa como categoría / total del mismo conjunto × 100. Las categorías deben ser excluyentes. Aclará la ruta, el método, el ambiente, la ventana y el límite de tiempo. Para los timeouts, el denominador debe incluir todos los intentos sujetos a ese límite.
No mezcles intentos con operaciones lógicas. Cada intento tiene su resultado; el resultado final determina si la operación tuvo éxito. No sumes las finalizaciones posteriores del servidor.
| Categoría | Qué cuenta | Qué revisar |
|---|---|---|
| Éxito | Resultado aceptado dentro del límite de tiempo | Cumplimiento del objetivo |
| 4xx de negocio | Stock insuficiente o cupón inválido | Reglas y flujo de compra |
| Otros 4xx | Autenticación, permisos o solicitud incorrecta | Credenciales y contrato de API |
| 5xx | Falla del servidor no clasificada como timeout | Aplicación y dependencias |
| Timeout | Límite de tiempo vencido en el punto observado | Colas y presupuesto de tiempo |
| Falla de red | Fallo sin respuesta HTTP válida | Conexiones y disponibilidad |
| Otra cancelación | Cancelación no atribuida a timeout o red | Desconexiones y propagación |
# Porcentaje de intentos con timeout, por ruta, en 15 minutos.
# Requiere registrar una categoría final por intento;
# el denominador incluye todos los intentos sujetos al límite de tiempo.
100 *
sum by (route) (
  rate(http_requests_total{
    service="checkout-api",
    outcome="timeout"
  }[15m])
)
/
sum by (route) (
  rate(http_requests_total{
    service="checkout-api"
  }[15m])
)
Cuando p99 se aleja de p50, buscá colas, contención, reintentos o dependencias lentas. Cruzá esa diferencia con el volumen, la concurrencia, los 5xx y los timeouts de la misma ventana. Investigá los aumentos de 4xx por separado.
En las trazas, seguí el camino crítico de carrito, stock, órdenes y envíos. Revisá por separado los webhooks asíncronos y sus reintentos: una demora posterior no necesariamente explica la latencia de respuesta de la orden.
Con p95, p99 y las tasas calculadas, comprobá los resultados con pruebas controladas. Usá curl --write-out y un identificador de correlación para comparar los tiempos del cliente con el log y la traza de la misma solicitud. Repetí la prueba varias veces y guardá el código HTTP y el tamaño de la respuesta. El comando y la URL son ejemplos: reemplazalos por los de tu entorno de pruebas.
curl -sS -o /dev/null \
  -w 'http=%{http_code}\nbytes=%{size_download}\ndns=%{time_namelookup}s\nconnect=%{time_connect}s\ntls=%{time_appconnect}s\npretransfer=%{time_pretransfer}s\nttfb=%{time_starttransfer}s\ntotal=%{time_total}s\n' \
  'https://api.ejemplo.invalid/stock/123'
Los tiempos son acumulativos: time_connect incluye el establecimiento de la conexión TCP, time_starttransfer mide hasta el primer byte y time_total, hasta el final de la transferencia. Para HTTPS, estimá el tiempo de TLS con time_appconnect - time_connect.
Con k6, simulá carga realista de carrito, stock, órdenes y cotización de envíos en escenarios separados. Etiquetá las solicitudes por flujo. Usá usuarios virtuales para sesiones que esperan respuestas, o una tasa de llegada fija para iniciar operaciones a un ritmo definido.
Registrá el ambiente, la versión, la duración, la carga, la región, los datos de prueba, el tamaño del payload y la caché. Si el generador no sostiene la carga, la prueba no valida la capacidad esperada. Preferí un entorno espejo. Si probás en producción, usá una identidad de prueba autorizada, una tasa baja y endpoints limitados, sin pagos ni acciones irreversibles.
Probá fallas y reintentos bajo las mismas condiciones. En un entorno controlado, inyectá demoras, errores de dependencia y conexiones rechazadas. Verificá la duración, la clasificación y la correlación en métricas, logs y spans. Comprobá también que la alerta respete su condición sostenida. Seguí observando la operación después del timeout: revisá los eventos asíncronos y el estado final.
Diferenciá cada operación de sus intentos con operation_id, attempt_number, retry_reason, idempotency_key y parent_trace_id. Probá el backoff, el jitter y el límite de reintentos.
Para crear órdenes, usá un merchant de prueba dedicado, clientes sintéticos, pagos de prueba e inventario aislado. Conservá la misma clave de idempotencia al reintentar la misma operación y verificá que no se genere otra orden. Evitá envíos y notificaciones reales.
Después de aplicar una corrección, repetí la carga bajo las mismas condiciones. Reconciliá carritos, órdenes, reservas, webhooks y reintentos para comprobar que la limpieza quedó completa. Si el resultado coincide con las métricas, llevá estos cortes a tableros y alertas.
Con las métricas validadas, llevá esos cortes a tableros y alertas para seguir cada flujo de compra.
Armá un tablero por flujo - carrito, stock, órdenes y envíos - con volumen, p50/p95/p99, éxito, error y timeout. Sumá datos de cola, reintentos y dependencias críticas. Filtrá por flow, endpoint, método HTTP, ambiente, región, proveedor y código de estado. No uses IDs de clientes ni URLs completas como etiquetas.
Agregá las señales de cada flujo: tiempo de precio y promociones en carrito, fallos de reserva en stock, duplicados en órdenes y latencia del transportista en envíos. Mantené un formato local uniforme para ms y %.
Vinculá los paneles con muestras de trazas y logs correlacionados. Así podés investigar qué pasó detrás de cada pico.
Definí objetivos por endpoint según su impacto en la compra y compará períodos equivalentes por región y campaña. Anotá en la serie temporal los despliegues, las campañas, las importaciones de catálogo, los incidentes de proveedores y los cambios de configuración.
Dispará alertas cuando p95 o p99 superen el objetivo durante 10 minutos, siempre que haya volumen suficiente. Configurá alertas de errores y timeouts por separado. Prestá atención a los aumentos de p99 aunque p50 se mantenga estable.
Mantené también chequeos de disponibilidad independientes: sin tráfico, un endpoint caído puede parecer saludable.
Ejemplo hipotético de alerta.
alert: CartAddHighTailLatency endpoint: "POST /cart/items" region: AR-BUE flow: cart current_p95_ms: 1.850 baseline_p95_ms: 620 current_p99_ms: 4.900 baseline_p99_ms: 1.400 error_rate: 2,1% timeout_rate: 0,7% traffic_5m: 3.240 requests condition: "p95 > 1.000 ms for 10 minutes and traffic_5m >= 500" owner: Checkout Platform trace_query: "dashboard://traces?endpoint=POST%20/cart/items®ion=AR-BUE" runbook: "wiki://runbooks/cart-add-latency" severity: high
Cuando salte una alerta, abrí la traza y seguí la dependencia que explica la cola de latencia.
Priorizá según las compras afectadas, p99 y errores/timeout. Desde la alerta, buscá qué dependencia consume el tiempo.
Después de corregir el problema, compará ventanas con tráfico, región y mezcla de endpoints equivalentes. Que mejore el promedio no alcanza si empeora la cola lenta.
Ejemplo hipotético de
POST /ordersen AR-BUE.
Métrica Antes Después p95 2.300 ms 780 ms p99 6.800 ms 1.450 ms Tasa de error 2,4% 0,6% Tasa de timeout 1,1% 0,2%
Después del despliegue, dejá la alerta activa y verificá que no haya regresiones en otra región o endpoint. Confirmá también que las órdenes se creen correctamente y que el stock mantenga su consistencia.
Aplicá el mismo esquema a APIs, colas y webhooks: medir, alertar y confirmar la entrega. Para los flujos de WhatsApp e Instagram conectados a Burbuxa, seguí la cadena API de tienda → cola → handler de webhook → confirmación.
En cada evento, registrá received_at, queued_at, started_at, completed_at, acknowledged_at, trace_id, event_id y attempt. Deduplicá por event_id.
Medí la espera en cola, el procesamiento y la entrega. Configurá alertas por backlog, fallos del handler, reintentos y entregas demoradas.
Un HTTP exitoso no confirma la entrega del mensaje. Registrá la confirmación cuando esté disponible. Si no la recibís, marcá el estado como pendiente, no como exitoso. Estos tableros corresponden a tu instrumentación: no presuponen herramientas de monitoreo ni acceso a trazas internas de Burbuxa.
Con la medición definida, revisá que el monitoreo no deje huecos. Verificá la cobertura de carrito, stock, órdenes y envíos. Dejá claro qué tramo mide cada métrica: extremo a extremo, gateway a servicio o procesamiento interno.
Antes de validar los datos, conciliá métricas, logs y trazas de la misma ventana de tiempo. Comprobá que las categorías de resultado sumen el total y que los reintentos estén separados o vinculados a la solicitud original. Confirmá p50, p95, p99 y las tasas de error y timeout por endpoint.
Después de cada cambio, repetí las pruebas con la misma carga y ventana de referencia. Compará los resultados con la línea de base y verificá las alertas. Si el cambio cumple los objetivos sin regresiones, dejalo listo; si no, volvé a diagnosticar.
Checklist de cierre:
Medí la latencia con los percentiles p95 y p99, no con promedios: muestran mejor lo que viven quienes sufren las mayores demoras. Una respuesta de menos de 100 ms se percibe como instantánea; entre 100 y 300 ms, resulta aceptable. A partir de 1 segundo, aumenta el riesgo de abandono.
Estos son los objetivos: p95 < 200 ms para endpoints críticos, menos de 100 ms para consultas GET y un máximo de 500 ms para pagos POST. En checkout, un p99 > 500 ms requiere atención inmediata.
No hay un número mágico de solicitudes para confiar en el p99: la precisión aumenta con el volumen de tráfico. Con pocas muestras, un evento aislado puede hacer que el valor cambie mucho y no represente bien el comportamiento habitual.
En vez de buscar una cantidad mínima, priorizá el monitoreo constante. Usá herramientas de APM para seguir la tendencia del p99 y configurá alertas cuando supere los umbrales que definiste: por ejemplo, 500 ms en el checkout.
Separá la recolección de datos del flujo principal. Usá gateways de APIs para centralizar las métricas sin recargar el código interno, y mantené las herramientas de observabilidad fuera de la ruta crítica.
En los flujos críticos, procesá el trabajo de forma asíncrona: respondé de inmediato con 200 o 201 y enviá el trabajo a una cola durable. Así evitás bloqueos y timeouts. Configurá alertas con umbrales dinámicos para detectar la saturación a tiempo.