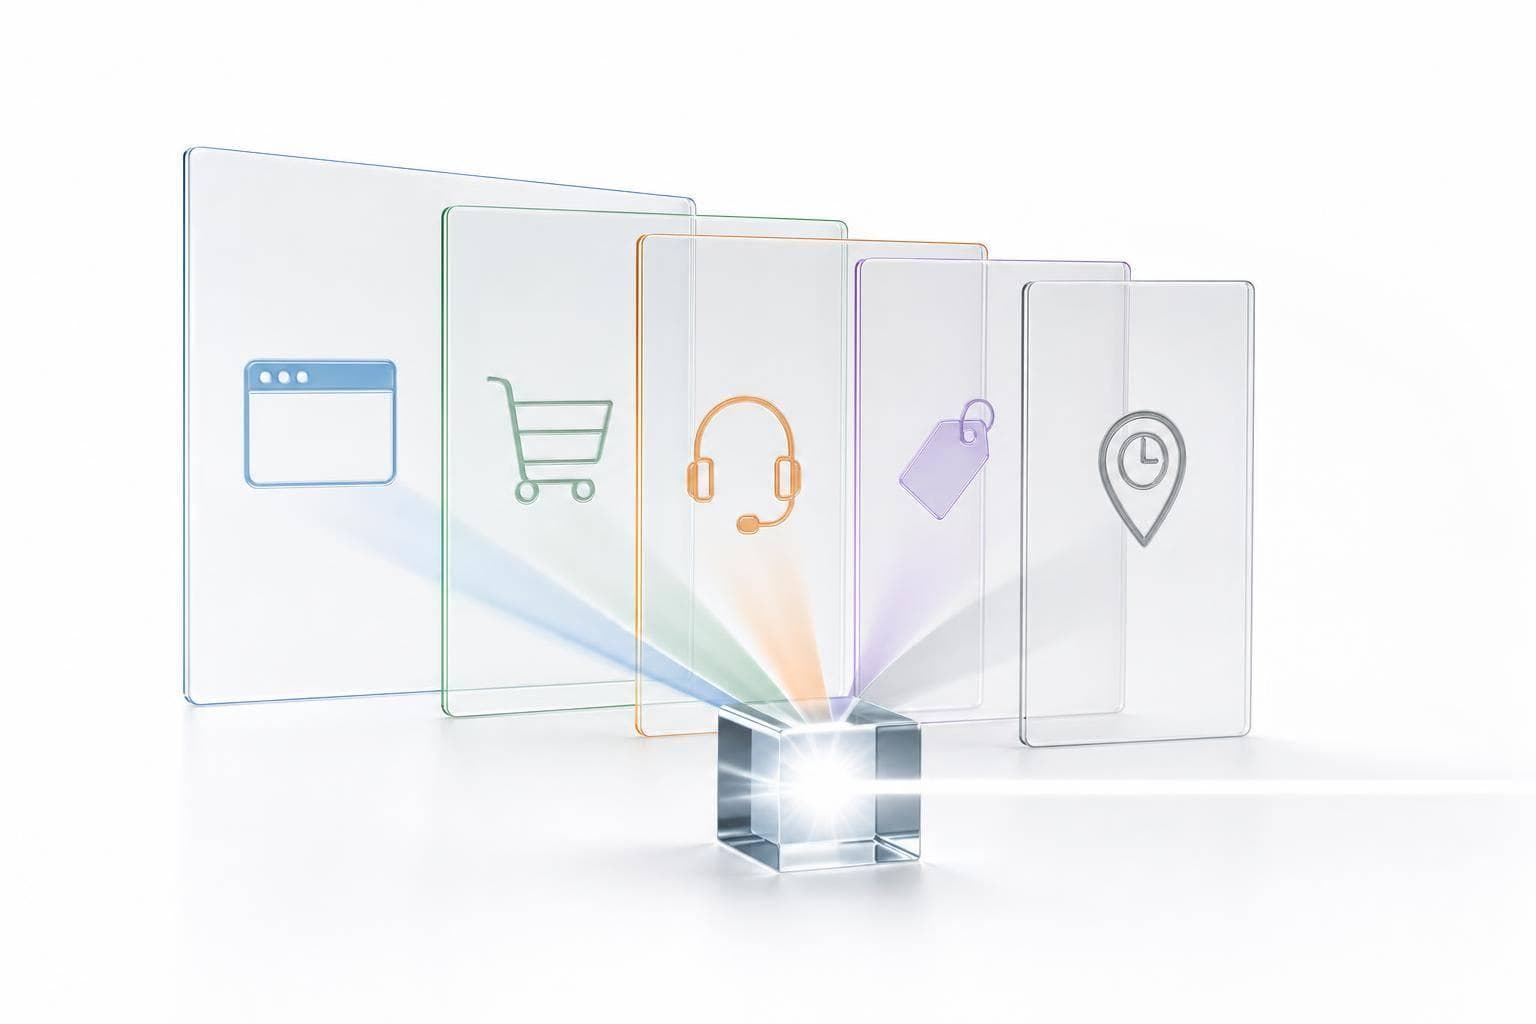
Si me preguntás qué necesitan estos algoritmos para funcionar bien, la respuesta corta es esta: usan datos de cliente, catálogo y contexto; y fallan cuando esos datos llegan mal, tarde o partidos.
En ecommerce, yo lo bajaría a algo simple:
Si una de esas patas falla, pasa lo de siempre: recomendaciones sin sentido, mensajes fuera de momento, productos agotados y cuentas duplicadas entre tienda, CRM y WhatsApp. No hace falta un modelo raro para que salga mal; alcanza con eventos duplicados, IDs rotos o inventario desactualizado.
También me quedo con tres datos del artículo que pegan directo:
En otras palabras: la personalización predictiva no depende tanto del modelo como de la higiene del dato.
Para ordenarlo rápido, yo lo resumiría así:
| Grupo de datos | Qué le da al sistema | Qué se rompe si falla |
|---|---|---|
| Navegación y compras | Intención, afinidad, recompra, LTV | Recomienda mal y manda mensajes fuera de tiempo |
| Soporte, chats y reseñas | Fricción, satisfacción, riesgo de abandono | Insiste con promos cuando el cliente viene de un problema |
| Catálogo e inventario | Qué producto mostrar, a qué precio y con qué variante | Empuja SKUs sin stock, precios viejos o talles erróneos |
| Contexto | Momento, canal, ubicación, dispositivo | Mezcla conductas distintas y pierde relevancia |
| Identidad unificada | Une tienda, CRM y mensajería en un solo perfil | Duplica contactos y corta el historial del cliente |
La idea de fondo es simple: si quiero predecir bien, primero tengo que unir, limpiar y actualizar los datos. Recién ahí la personalización sirve para vender más y errar menos.
Impacto de la Mala Calidad de Datos en eCommerce
A partir de ahí, las señales del cliente arrancan con dos cosas muy concretas: lo que navega y lo que compra. Los eventos de navegación y el historial de pedidos dejan ver intención de compra, gusto por ciertas categorías y hasta el momento en que una recompra puede estar por caer.
Los eventos que más sirven son las vistas de producto, las visitas a categorías, las búsquedas internas, el agregado al carrito, el inicio del checkout y el retiro del carrito.
El retiro del carrito suele prender una alarma. Puede marcar fricción, sensibilidad al precio o falta de stock, sobre todo cuando coincide con cambios de precio o quiebres de inventario.
Para que esos eventos sirvan de verdad, cada uno necesita como mínimo:
Sin eso, el sistema puede tomar sesiones duplicadas como si fueran usuarios distintos. Y también puede perder la relación entre la navegación y el pedido que llega después. Dicho simple: ve movimiento, pero no entiende la historia completa.
| Evento de navegación | Señal que aporta | Riesgo de calidad frecuente | Acción de limpieza recomendada |
|---|---|---|---|
product_view | Afinidad de categoría/producto | Clics accidentales o bots | Filtrar por tiempo mínimo en página |
search_term | Intención explícita | Errores tipográficos o búsquedas sin resultados | Normalizar textos y mapear al catálogo |
add_to_cart | Alta intención de compra | Carritos fantasma sin expiración | Asignar timestamp de expiración de intención |
remove_from_cart | Sensibilidad al precio o fricción | Remociones accidentales | Cruzar con cambios de precio o alertas de stock |
session_timing | Actividad real de sesión | Tabs inactivas o bots | Medir actividad para descartar sesiones inactivas o bots |
Cuando esa intención se confirma con una compra, el historial ayuda a afinar mucho más la predicción.
El historial de pedidos alimenta modelos de RFM y LTV. La fecha, el mix de productos, las cantidades y los descuentos muestran recencia, frecuencia, ticket y sensibilidad al precio.
Si una persona compra cada 30 a 45 días, el sistema puede anticipar la reposición antes de que se quede sin producto. Y si usa cupón siempre, el algoritmo la clasifica como sensible al precio, así que evita empujarle upsells premium sin algún incentivo. Tiene lógica: si el bolsillo manda, el mensaje también tiene que cambiar.
Los errores más comunes acá son bastante conocidos: IDs faltantes, zonas horarias mal cargadas, órdenes duplicadas, monedas mezcladas y estados de devolución desactualizados.
| Campo de transacción | Uso en el algoritmo | Problema de datos frecuente | Regla de validación |
|---|---|---|---|
| Fecha y hora del pedido | Recencia y ciclos de reposición | Diferencias de zona horaria | Convertir todo a UTC en formato ISO 8601 |
| ID de cliente | Resolución de identidad / LTV | Perfiles duplicados (invitado vs. registrado) | Mapear a un ID unificado interno |
| Mix de productos / SKUs | Preferencia de categoría y cross-sell | SKUs eliminados en el historial | Mantener una tabla maestra de SKUs con historial |
| Descuentos y cupones | Sensibilidad al precio | Doble conteo o superposición de promociones | Registrar valor neto y bruto por separado |
| Total del pedido | Valor monetario (RFM) | Formato incorrecto o moneda mixta | Forzar formato: AR$ 12.345,67 |
| Devoluciones y cancelaciones | Satisfacción y riesgo | Actualizaciones de estado con demora | Sincronizar el estado en tiempo real vía webhooks |
Con esa sincronización en tiempo real, pedidos, clientes e inventario quedan disponibles para ventas y soporte mediante campañas automatizadas en WhatsApp e Instagram.
Si la navegación y las compras muestran intención, el soporte y las reseñas muestran fricción. Más allá de lo que una persona mira o compra, estos datos dejan ver satisfacción, problemas sin resolver y hasta riesgo de abandono.
Las variables más útiles del historial de soporte - razón de contacto, estado de resolución, cantidad de contactos repetidos, derivación a supervisor y tiempo de respuesta - sirven para detectar riesgo. Los clientes que califican el soporte por debajo de 3/5 son 88% más propensos al abandono, y quienes contactan soporte 3 o más veces en 30 días abandonan 2 a 3 veces más.
Eso tiene una lectura muy concreta. Si alguien tuvo un problema logístico hace poco, conviene bajar la presión promocional y priorizar un seguimiento que confirme que todo quedó resuelto. Y si un cliente escaló su reclamo a un supervisor, lo mejor es marcarlo para atención humana en el próximo contacto, en vez de mandarlo al flujo automático de siempre.
El canal también pesa. WhatsApp, Instagram DM, email y teléfono piden distinto tono, otra velocidad de respuesta y otro formato. Plataformas como Burbuxa juntan esas conversaciones en un historial único por cliente. Eso ayuda a responder con contexto y evita errores básicos, como sugerir productos sin stock.
Cuando la fricción no aparece en tickets, suele aparecer en la experiencia con el producto. Las reseñas aportan dos señales claras: calificación y comentarios. La calificación positiva empuja más ventas que el volumen de reseñas, y las reseñas negativas pesan más que las positivas.
Para usar esas señales, primero hay que normalizarlas y unirlas al cliente y al SKU. El proceso incluye limpiar el texto, detectar temas y vincularlos tanto al SKU como al cliente. Con eso, el sistema puede bajar la visibilidad de un calzado con muchas quejas de que corre chico para clientes con historial de devoluciones por talle. Y, al mismo tiempo, puede reforzar guías de medidas o mostrar fotos de referencia.
En la práctica, conviene ordenar estas fuentes así:
| Tipo de dato | Estructura | Valor predictivo | Pasos de limpieza |
|---|---|---|---|
| Soporte / tickets | Semi-estructurada (tags, estados, tiempos) | Alto para abandono y fricción | Estandarizar razón de contacto y estado de resolución; unificar etiquetas duplicadas |
| Reseñas | Semi-estructurada (calificación + comentarios) | Alto para fit de producto y categoría | NLP en español para sentimiento y temas; vincular a SKU y variante |
| Encuestas (CSAT / NPS) | Estructurada (escala numérica + campo abierto) | Alto para intención de recompra y riesgo | Normalizar escalas distintas a una métrica unificada; asociar a ID de cliente y pedido |
La clave está en algo simple: vincular cada registro al cliente y al SKU. Sin ese cruce, soporte y reseñas quedan como ruido. Con ese cruce, pasan a servir para personalizar de verdad.
Con estas señales ya limpias, el paso siguiente es cruzarlas con catálogo, stock y contexto para no recomendar mal.
El algoritmo solo debería empujar productos que se pueden vender de verdad: la variante correcta, stock real y precio al día. Si esa base falla, la personalización se rompe. ¿El resultado? Variantes equivocadas, precios viejos o productos sin stock.
Si faltan datos como talle, color o material, el algoritmo no puede cruzar bien las preferencias del usuario. Entonces termina mostrando productos genéricos o variantes que no van. Y si el stock no se sincroniza a tiempo, el sistema sigue empujando productos agotados. En Argentina, eso suele terminar en estrategias para recuperar carritos abandonados y mensajes por WhatsApp o Instagram.
La disponibilidad no debería tratarse como un simple filtro al final. Conviene usarla como señal de ranking. Si un SKU tiene pocas unidades durante una campaña con mucho tráfico, debería perder lugar frente a otro con stock suficiente. Con los precios en AR$ pasa algo parecido: si no se actualizan rápido, el modelo puede destacar promos que ya no están vigentes y eso genera tickets de soporte o pérdida de confianza.
| Atributo | Uso en el algoritmo | Error frecuente (AR) | Regla de validación |
|---|---|---|---|
| SKU | Identificar producto y variante; medir performance por ítem | SKUs duplicados o reutilizados entre temporadas | Unicidad obligatoria; patrón fijo por categoría |
| Categoría / Subcategoría | Matching con intereses del usuario; sustitutos y similares | Mezcla de categorías sin jerarquía clara | Taxonomía fija; revisión periódica |
| Precio en AR$ | Ranking por sensibilidad al precio; upsell | Precio no actualizado o formato incorrecto | Sincronización frecuente; formato AR$ 1.234,56 |
| Descuento (%) / monto | Destacar promociones; controlar intensidad vs. margen | Descuento aplicado en banner pero no en el dato de producto | Campos separados para precio base, precio promo y % de descuento |
| Talle (cm / escala) | Personalización de fit; excluir variantes sin stock | Talles en texto libre o variantes incompletas | Escala estándar S/M/L o numérica; medida en cm cuando aplique |
| Estado de stock | Excluir ítems agotados; controlar frescura de recomendaciones | Actualizaciones manuales o no sincronizadas | Sincronización frecuente; campo en_stock; automático cuando cantidad > 0 |
| Cantidad en stock | Evitar promover ítems con stock muy bajo en campañas masivas | Sin cantidades por SKU; solo flag genérico | Stock numérico por SKU; mínimo de unidades para entrar en recomendaciones |
| Restricciones de envío | Excluir ítems de zonas sin cobertura; adaptar por provincia | "Envío nacional" sin cobertura real | Campos por provincia o ciudad habilitada; validación contra cobertura logística |
Burbuxa sincroniza productos, variantes, inventario, descuentos y precios en tiempo real.
Con estos campos limpios, el algoritmo ya puede pasar de “qué existe” a “qué conviene mostrar ahora”.
Una vez que el catálogo está ordenado, el contexto define a quién mostrarle cada producto y en qué momento.
En Argentina, buena parte del comercio conversacional pasa por mobile, sobre todo en WhatsApp e Instagram. Ahí el usuario suele buscar respuestas rápidas y productos simples de comprar en el momento. En desktop, la lógica cambia un poco: hay más comparación, más lectura de especificaciones técnicas y más ganas de mirar opciones de pago. Si el algoritmo no distingue el dispositivo, mezcla conductas que no son iguales.
La ubicación también cambia la relevancia. Recomendar camperas pesadas en el sur del país durante los meses fríos puede tener sentido. Hacer lo mismo en provincias más cálidas, no tanto. Y no es solo una cuestión de clima. La logística pesa mucho: un electrodoméstico grande, medido en kg y cm, puede tener restricciones de envío según la zona. Si el algoritmo no mira ese dato, termina prometiendo una entrega que después no se puede cumplir.
El horario también mueve prioridades. Los fines de semana suelen empujar más la interacción con campañas en Instagram y las compras por impulso. En temporada, la regla práctica es ajustar el ranking según la estación: subir productos de invierno cuando bajan las temperaturas y bajarles exposición cuando vuelve el calor. Además, si evitás promover ítems con stock bajo en momentos de alta demanda, bajás la chance de frustrar al usuario antes de que llegue al checkout.
El problema, en la práctica, es bastante directo: la misma persona puede aparecer como registros distintos en la tienda, el CRM y el chat. Por eso hay una capa que no se puede saltear: unir y limpiar los datos para armar un perfil único de cliente. Cuando el catálogo y el contexto ya están en orden, queda la parte que más suele arruinar la personalización: conectar clientes y conversaciones entre canales.
Conviene empezar por los identificadores más firmes: email y teléfono. Después, usar el ID de cliente de la plataforma. Y al final dejar el ID de dispositivo o las cookies anónimas de sesión, que recién se atan al perfil cuando la persona inicia sesión o compra.
También hace falta poner orden en el formato. Normalizá los teléfonos a E.164 y guardá los IDs de Instagram y WhatsApp dentro de un mismo perfil.
En Argentina esto pesa mucho más de lo que parece. Muchas compras arrancan en Instagram y terminan en WhatsApp con un link de pago. Si esos eventos no quedan unidos bajo un solo registro, medir bien el LTV y la recompra se vuelve un lío. Y cuando esa traza se corta, el modelo puede terminar leyendo a la misma persona como comprador frecuente en un canal y como usuario nuevo en otro.
Los problemas más comunes no suelen nacer en el modelo. Aparecen antes, en la unión de fuentes.
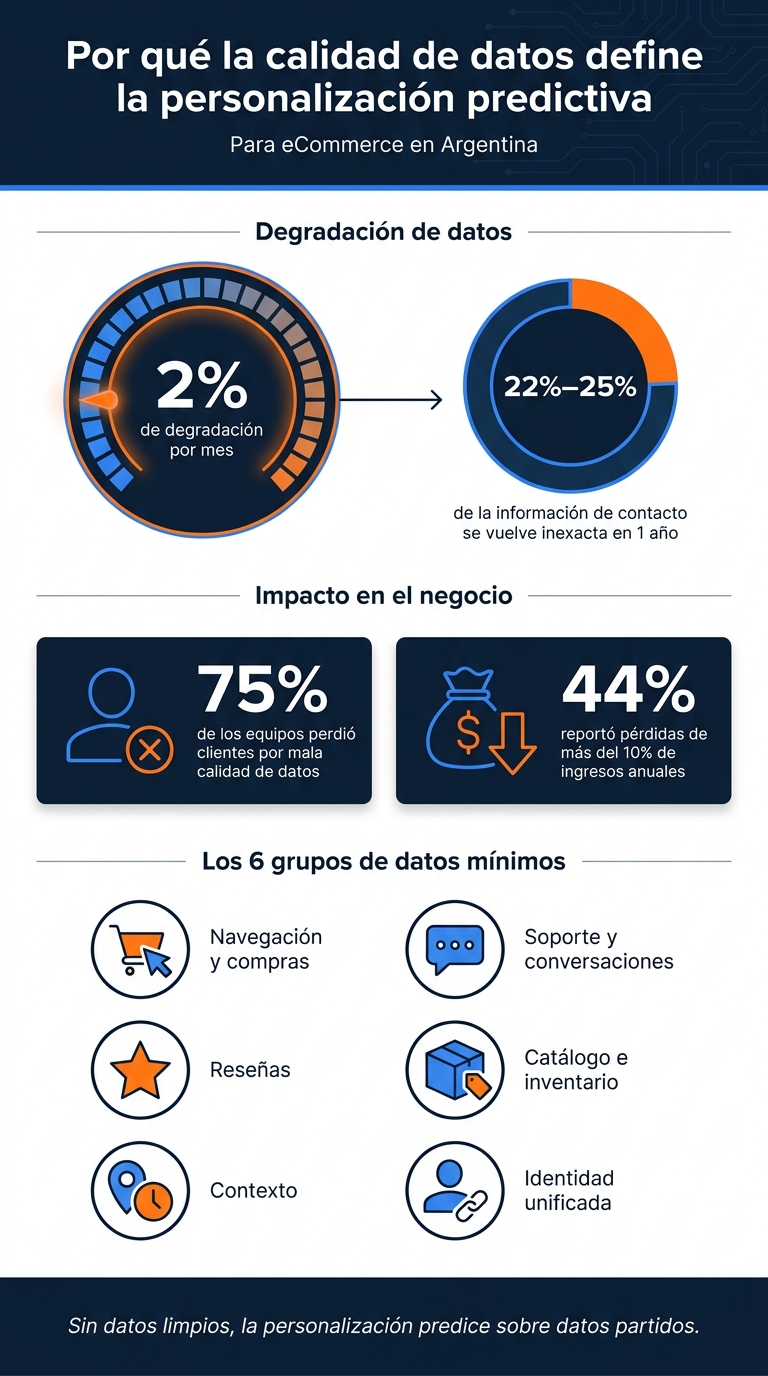
Según datos de Validity, el 75% de los equipos reportó que la comunicación duplicada o inadecuada por mala calidad de datos les hizo perder clientes, y el 44% estimó pérdidas de más del 10% de sus ingresos anuales por CRM de baja calidad.
| Error de datos | Síntoma visible | Causa probable | Acción correctiva |
|---|---|---|---|
| Contactos duplicados | El cliente recibe la misma campaña dos veces o ve recomendaciones distintas en web y WhatsApp | Perfiles creados desde canales distintos sin reglas de matching | Deduplicación por email + teléfono; procesos semanales; ID único de cliente |
| IDs de usuario faltantes | El historial de navegación no influye en las recomendaciones; sesiones anónimas nunca se vinculan a compras | Sin captura de login antes del checkout; tracking incompleto en flujos de mensajería | Capturar email o teléfono en pasos clave; asegurar que los eventos de mensajería incluyan ID de cliente |
| Timestamps incorrectos o mezclados | Mensajes de carrito abandonado enviados a destiempo; campañas estacionales fuera de fecha | Sistemas con zonas horarias distintas o formatos DD/MM vs MM/DD mezclados | Estandarizar a ISO 8601 y la zona horaria America/Argentina/Buenos_Aires |
| Diferencias de stock entre store y mensajería | Recomendaciones de productos sin stock por WhatsApp; precios distintos entre el sitio y el chat | Inventario actualizado solo en la plataforma, sin sincronización con los canales de mensajería | Sincronización en tiempo real; filtro obligatorio de stock disponible en la lógica de recomendación |
| Registros de consentimiento incompletos | Usuarios dados de baja reciben promos; clientes de alto valor quedan bloqueados por error | Consentimiento capturado en un sistema pero no replicado a los demás | Esquema de consentimiento unificado por canal; sincronización inmediata ante cualquier cambio |
Burbuxa centraliza cliente, inventario y pedidos en un registro único para evitar copias separadas por canal.
La base mínima tiene seis grupos de datos:
Cada grupo necesita identificadores limpios, formatos consistentes y actualización frecuente. Según Informatica, los datos de clientes se degradan cerca del 2% por mes, lo que implica que alrededor del 22%–25% de la información de contacto puede volverse inexacta en un año.
Dicho simple: la higiene de datos no se resuelve una sola vez. Hay que sostenerla todo el tiempo. Sin identidad unificada, limpieza y sincronización, la personalización termina prediciendo sobre datos partidos.
No existe un dato mágico. Lo que más pesa es juntar señales de intención claras con un perfil unificado.
Arrancá por la navegación y el comportamiento: clics, búsquedas, tiempo en página y productos sumados al carrito, junto con el historial de compras. Ahí suele estar la diferencia entre alguien que solo está chusmeando y alguien con interés de verdad.
La limpieza y la actualización de datos tienen que hacerse de forma constante si querés sostener la precisión. No alcanza con poner todo en marcha una vez y listo: si la base se ensucia, las respuestas también.
Por eso, la sincronización de catálogo, inventario, pedidos y clientes conviene hacerla en tiempo real. Ese punto evita errores bastante comunes, como recomendar productos sin stock o mostrar precios desactualizados. Y seamos sinceros: pocas cosas generan más fricción que prometer algo que después no se puede vender.
Además, los modelos de IA necesitan revisión periódica. Si el rendimiento baja, hay que reentrenarlos. En el caso de los pronósticos de demanda y las series temporales, suele recomendarse hacer ajustes trimestrales y anuales.
Se unifica todo al consolidar los registros en un perfil único, usando identificadores en común como teléfono, email o ID de cliente.
Burbuxa centraliza de forma automática los datos de clientes, pedidos, compras e interacciones. Además, conecta las conversaciones de WhatsApp o Instagram con el historial de navegación y las transacciones de la tienda.
¿El resultado? Se evitan duplicados y se obtiene un contexto unificado para cada cliente.