PCA y clustering ayudan a decidir qué pedidos revisar primero, no a confirmar fraude. El punto de partida es usar datos disponibles al momento de la compra, separar entrenamiento y evaluación por fecha y limitar las alertas a la capacidad del equipo.
PCA reduce variables correlacionadas; K-Means agrupa transacciones por cercanía y DBSCAN por densidad. Conservar el 90 % de la varianza puede servir como prueba inicial, pero no garantiza detectar los casos de fraude.
El proceso combina cuatro pasos:
La prueba final no es que los grupos se vean separados: es que permitan priorizar mejor sin retener pedidos legítimos innecesariamente.
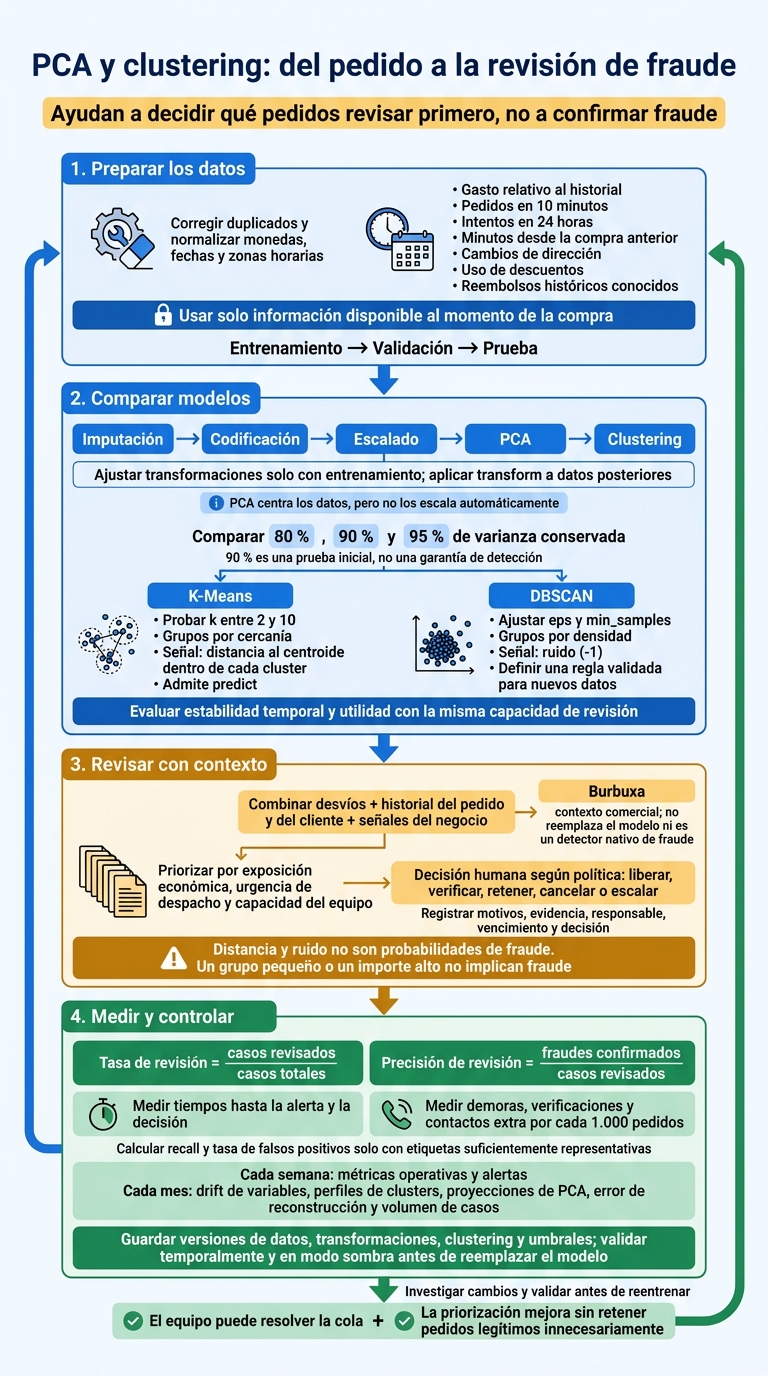
PCA y clustering: del pedido a la revisión de fraude
Eliminá duplicados con una regla documentada:
Por ejemplo, conservá el evento más reciente para la misma combinación de pedido e intento de pago, sin borrar reintentos legítimos.
Verificá que los importes no sean negativos, las monedas estén reconocidas y las fechas sean coherentes. Registrá cada corrección.
Interpretá
ARS $125.000,50como125000.50, con la monedaARSen un campo separado. Leé13/11/2026como 13 de noviembre de 2026 y asociá14:30conAmerica/Argentina/Buenos_Aires. Guardá también el instante en UTC y conservá la hora local para analizar hábitos.
Construí las variables con ventanas retrospectivas y ordená los eventos por fecha. Usá solo la información disponible al momento de cada compra: un reembolso registrado después no forma parte de su historial. Esta tabla te sirve como guía para implementar las variables y priorizar pedidos:
| Campos originales | Variable derivada | Señal | Preparación |
|---|---|---|---|
| Importe y moneda | Importe frente a la mediana reciente del cliente | Gasto atípico | Separar monedas; contemplar inflación; exigir historial mínimo |
| Fecha, hora e intentos | Pedidos en 10 minutos; intentos en 24 horas; minutos desde la compra anterior | Velocidad atípica | Unificar zonas horarias |
| Facturación y entrega | Discrepancia de provincia; dirección nueva | Cambio de patrón | Normalizar ubicaciones; distinguir faltantes |
| Descuentos | Descuento sobre importe bruto; reutilización del cupón | Uso inusual de promociones | Convertir porcentajes a valores numéricos |
| Compras y reembolsos históricos | Tasa de reembolsos conocidos | Reembolsos frecuentes | Calcular la tasa histórica |
Encadená imputación, codificación, escalado y PCA en un Pipeline de scikit-learn. Ajustalo con fit solo sobre entrenamiento y usá transform para las transacciones futuras. Guardá el pipeline para producción.
Para los faltantes numéricos, considerá la mediana; para las categorías, un valor “desconocido”. Usá one-hot encoding en categorías pequeñas y agrupá las poco frecuentes. Miles de columnas de direcciones o productos pueden distorsionar las distancias: preferí agregados históricos y dejá afuera los identificadores originales.
El escalado estándar resta la media y divide por la desviación estándar. El escalado robusto puede ayudar cuando hay importes o conteos extremos. PCA centra los datos, pero no los escala automáticamente. Después, proyecta las variables en componentes lineales ordenados por varianza explicada.
Empezá conservando el 90 % de la varianza, pero no lo tomes como una garantía. Compará 80 %, 90 % y 95 % mediante validación temporal. Revisá la estabilidad del clustering, los falsos positivos y la recuperación de casos confirmados, siempre con la misma capacidad de revisión. Los componentes elegidos se usarán luego para agrupar transacciones y marcar outliers.
Ordená las variables por el valor absoluto de sus cargas en cada componente. Conservá el signo: te ayuda a interpretar los contrastes. Revisá el peso del importe, la velocidad y las discrepancias, y contrastalo con las variables originales antes de ponerle una etiqueta al componente. Un componente no equivale a una categoría de fraude.
| Aspecto | Fortaleza de PCA | Límite y acción práctica |
|---|---|---|
| Dimensionalidad | Resume variables correlacionadas | Puede perder señales raras; compará contra una versión sin PCA |
| Ruido | Reduce redundancia | Las campañas o la inflación pueden dominar la variación |
| Interpretación | Las cargas muestran qué variables influyen | Conservá las señales originales para explicar cada alerta |
| Visualización | Facilita el análisis de segmentos | Dos componentes pueden ocultar estructura presente en otros |
| Patrones no lineales | Ofrece una proyección lineal compacta | Puede perder relaciones no lineales; verificá también el espacio original |
| Anomalías | Puede destacar desvíos amplios útiles para priorizar la revisión | Las direcciones de baja varianza también pueden contener casos que ameritan revisión |
Usá los componentes de PCA para agrupar transacciones, detectar desvíos y priorizar la revisión humana de pedidos o pagos. El objetivo no es clasificar fraude automáticamente.
Ajustá el clustering sobre los componentes de entrenamiento. Con K-Means, probá valores de k entre 2 y 10 y distintas inicializaciones. Para elegir k, combiná inercia, criterio del codo, silhouette y estabilidad semana a semana. Silhouette va de −1 a 1: un valor cercano a 0 indica solapamiento. Buscá grupos que ayuden a revisar: tres clusters no equivalen a tres niveles de riesgo.
| Decisión | K-Means | DBSCAN |
|---|---|---|
| Cuándo usarlo | Grupos compactos de dispersión similar | Grupos irregulares con densidades comparables |
| Parámetros | n_clusters, inicialización y n_init | eps y min_samples |
| Señal de anomalía | Distancia al centroide para detectar transacciones alejadas dentro de cada cluster | Ruido (-1) según la densidad local |
| Uso operativo | Admite predict | Requiere una regla específica para nuevos datos |
Con DBSCAN, usá el gráfico de k-distancias para estimar eps. Probá combinaciones de eps y min_samples y evaluá el tamaño de los grupos, el porcentaje de ruido y la estabilidad temporal. Documentá en qué espacio de componentes medís las distancias y cualquier normalización adicional. Para los nuevos datos, definí una regla operativa: asignalos solo si cumplen la vecindad validada; de lo contrario, marcalos como “sin asignar”.
En inferencia, mantené fijas las transformaciones y el modelo. Con K-Means, usá predict y calculá la distancia al centroide asignado. Para auditar cada resultado, guardá la versión del modelo, la etiqueta de cluster, la distancia o densidad, las reglas aplicadas y la decisión final.
Uní las etiquetas con las variables originales. Revisá el volumen de cada cluster, la mediana y los percentiles de importe por moneda, la antigüedad del cliente, la concentración por dispositivo/IP/dirección y la frecuencia de intentos. Estos perfiles sirven para identificar segmentos, outliers y carga de revisión, no para crear categorías fijas de riesgo.
Contrastá el fraude confirmado, los contracargos y los reembolsos por separado de las entradas del modelo, con períodos de observación comparables. En K-Means, compará percentiles de distancia dentro de cada cluster, sin aplicar un corte global. En DBSCAN, distinguí núcleo, borde y ruido. Un grupo chico o un importe alto no implican fraude.
Combiná distancia, densidad y señales del negocio para ordenar la revisión. La siguiente grilla es hipotética: usala para priorizar, no para decidir fraude automáticamente. Ajustala con resultados históricos confirmados y según la capacidad de revisión.
Los percentiles de distancia y las etiquetas de ruido no son probabilidades de fraude. Reservá el escalamiento para evidencia independiente y políticas documentadas.
| Perfil del grupo | Distancia al centroide o densidad local | Señal extra | Acción |
|---|---|---|---|
| Grande y estable | Distancia mediana o zona densa | Historial consistente y sin alertas | Gestión habitual |
| Pequeño o estacional | Distancia moderada o baja densidad | Cliente recurrente con dispositivo y dirección consistentes | Desvío explicable |
| Atípico | Distancia alta dentro del cluster o ruido DBSCAN | Cliente nuevo, múltiples intentos y dispositivo compartido | Revisión prioritaria |
| Patrón histórico confirmado | Cualquier distancia o densidad | Fraude o incumplimiento confirmados | Escalamiento por política |
Con las alertas ya priorizadas, convertí cada una en un caso operativo. Registrá en el expediente el ID del pedido, la fecha y hora local en formato dd/mm/aaaa HH:mm, la versión del pipeline, el período de entrenamiento, el cluster, los scores de componentes y el índice de anomalía. Indicá también qué señal disparó la alerta: distancia al centroide, densidad o etiqueta de ruido.
Sumá los motivos, el responsable, la prioridad y el vencimiento. Dejá constancia de la evidencia consultada, los cambios de estado, la decisión y quién la aprobó. Priorizá por exposición económica, urgencia de despacho y capacidad del equipo, no por el score aislado.
Según la prioridad y la política, definí si corresponde liberar, verificar, retener, cancelar o escalar el pedido. Registrá la aprobación humana según una política documentada. Para cada retención, fijá un vencimiento y qué acción se tomará al cumplirse.
Restringí el acceso por rol y conservá solo los datos necesarios. Usá tokens o referencias de pago: no guardes números completos de tarjeta ni códigos de seguridad. Tokenizar no elimina las obligaciones de seguridad.
Conectá el expediente con los datos del pedido y del cliente para completar la revisión, sin mezclar el score con el contexto comercial. Los datos sincronizados de pedidos, clientes, descuentos y políticas de Burbuxa permiten verificar el historial comercial y las condiciones de una compra.
Usá Burbuxa como capa de contexto. Mantené PCA, clustering y priorización en un pipeline separado, conectado mediante identificadores. Burbuxa no reemplaza el modelo ni debe presentarse como un detector nativo de fraude.
Antes de integrarlo, verificá los permisos, los campos disponibles, la frecuencia de sincronización y el manejo de errores. Registrá qué información se consultó y cada derivación.
Después de derivar los casos, evaluá cómo funcionó la cola de revisión. Medí la **tasa de revisión - casos revisados / casos totales - ** y la **precisión de revisión - fraudes confirmados / casos revisados - **. Indicá cuántos casos siguen pendientes y separá fraude confirmado, sospecha y casos inconclusos.
Sumá el tiempo desde la transacción hasta la alerta y desde la alerta hasta la decisión. Medí también la fricción operativa: demoras, verificaciones y contactos extra por cada 1.000 pedidos. Calculá recall y tasa de falsos positivos solo cuando las etiquetas sean suficientemente representativas: los contracargos llegan tarde y la cola tiene sesgo de selección.
Revisá las métricas operativas y las alertas cada semana. Una vez al mes, monitoreá el drift en las distribuciones de variables, los perfiles de clusters, las proyecciones de PCA, el error de reconstrucción y el volumen de casos.
Investigá los cambios antes de ajustar umbrales: pueden deberse a promociones o fallas de integración. Si justifican reentrenar, probá la nueva versión con períodos posteriores y en modo sombra, sin afectar pedidos.
Conservá los escaladores, componentes, parámetros y versiones: las componentes de PCA y las etiquetas de cluster pueden cambiar entre ejecuciones. Antes de reemplazar el modelo, compará los resultados con las mismas métricas operativas.
Con la cola de revisión definida, probá el circuito con un piloto acotado. Usá datos depurados, variables disponibles al momento de decidir y una separación temporal entre entrenamiento, validación y prueba. Ajustá el escalador y el PCA solo con los datos de entrenamiento; después, aplicá transform en validación y prueba.
Si el flujo supera la validación temporal, evaluá K-Means y DBSCAN según su estabilidad, el tamaño de los grupos y su utilidad para el equipo en casos reales. Comprobá si agrupar transacciones y marcar desvíos ayuda a priorizar la revisión sin frenar pedidos legítimos.
Antes de escalar, revisá estos puntos:
Para escalar, exigí ambas condiciones: que el equipo pueda resolver la cola y que los resultados muestren una mejor priorización sin retener pedidos legítimos innecesariamente.
No hay una cantidad mínima predefinida de datos para probar K-Means. Empezá con un volumen que te permita identificar grupos representativos y ajustá K de a poco, según los datos disponibles y la precisión que buscás.
Podés usar solo transacciones legítimas como referencia del comportamiento normal. Con más operaciones, el modelo podrá detectar mejor las anomalías. Tu equipo podrá revisar los casos sospechosos y generar datos etiquetados para afinar el sistema.
En lugar de entrenar un modelo supervisado desde cero, usá detección de anomalías con transacciones legítimas para señalar desvíos sospechosos.
Revisá las alertas con tu equipo para confirmar los fraudes y generar etiquetas. Esas etiquetas te van a servir para entrenar modelos más precisos.
Mientras tanto, usá umbrales conservadores y ajustalos según las métricas de las muestras revisadas. Priorizá la precisión sobre la cantidad de alertas para no superar la capacidad de revisión de tu equipo.
Sin historial de compras, el análisis compara el pedido con transacciones de la misma categoría, región y canal, teniendo en cuenta la incertidumbre. Busca anomalías en el monto, la hora, el dispositivo y la frecuencia de los intentos de pago.
Burbuxa permite enviar automáticamente los casos de mayor riesgo a revisión humana. El analista puede evaluar la conversación en WhatsApp junto con el riesgo del producto y el contexto del pedido.