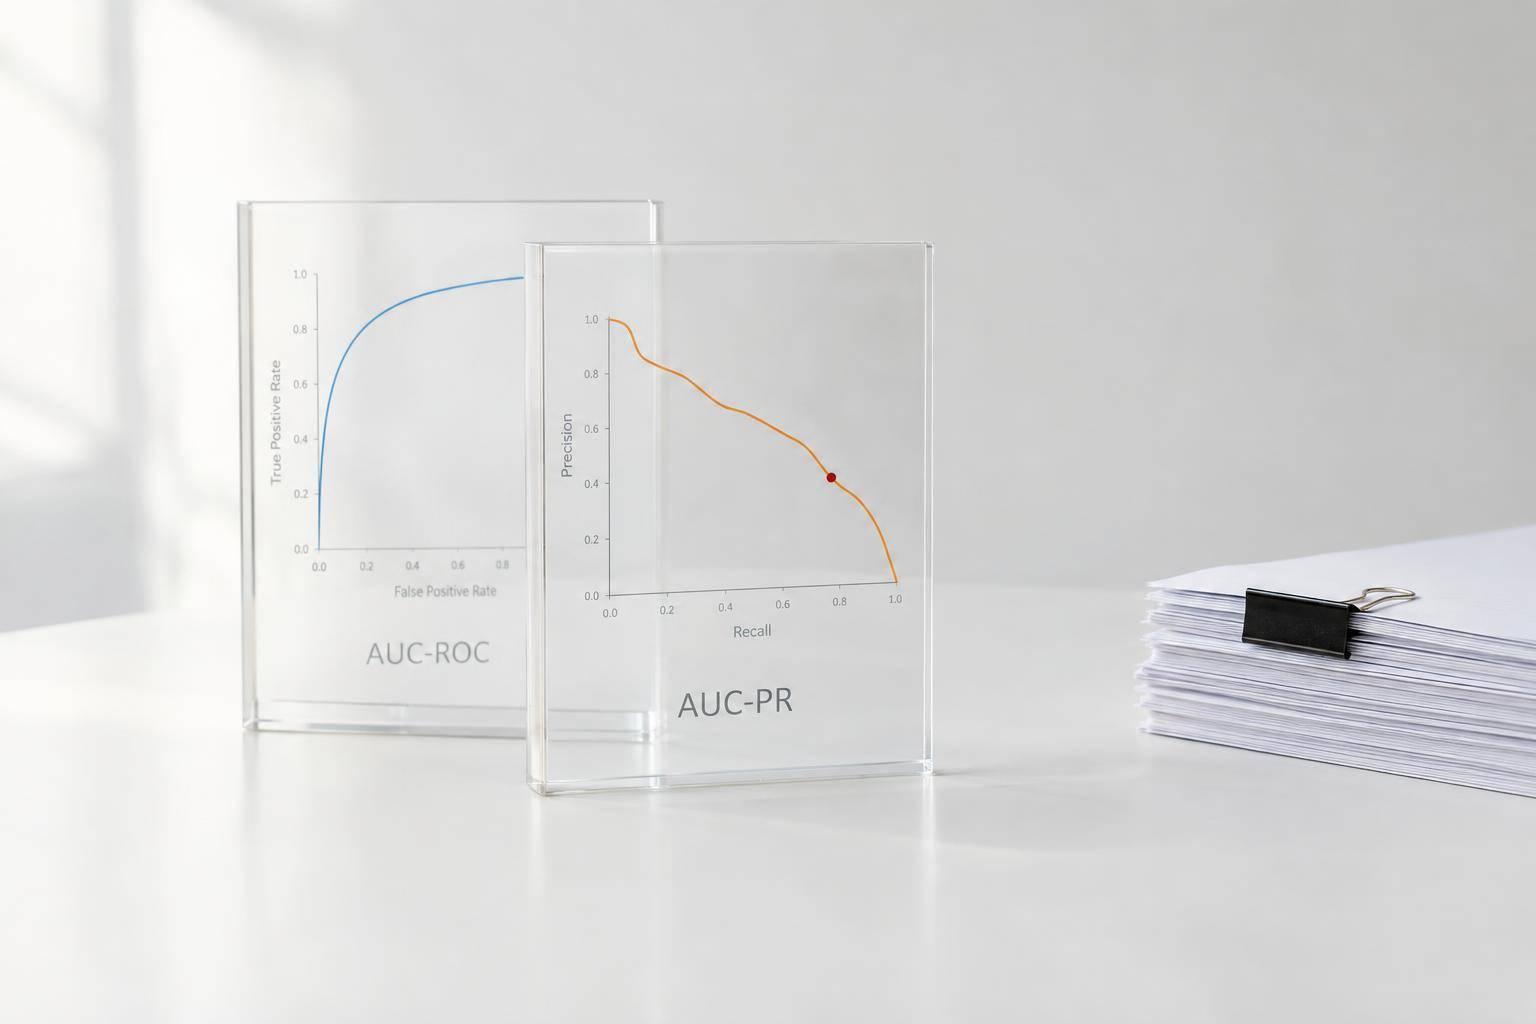
Cuando el fraude es poco frecuente, conviene priorizar AUC-PR y usar AUC-ROC como complemento. Pero el modelo y el umbral se eligen según la precisión, el recall, las revisiones disponibles y el costo de los errores.
La exactitud puede engañar: con un 0,1 % de fraude, aprobar todas las operaciones daría un 99,9 % de aciertos, sin detectar ningún fraude.
Comparación rápida
| Criterio | AUC-ROC | AUC-PR |
|---|---|---|
| Qué resume | Qué tan bien quedan ordenados los fraudes por encima de las operaciones legítimas. | La relación entre precisión y recall. |
| Frecuencia del fraude | Puede mantenerse igual si solo cambia la proporción de fraudes. | Cambia con esa proporción. |
| Qué revisar además del área | El recall dentro de la tasa de falsos positivos tolerable. | La precisión al recall necesario. |
La comparación debe usar los mismos datos y respetar el orden temporal. Además, corresponde aclarar si se informa Average Precision (AP) o área trapezoidal PR: no son lo mismo. El umbral se fija en validación y se evalúa en un conjunto de prueba intacto, con etiquetas maduras y una proporción de fraude representativa de producción.
La curva ROC muestra qué pasa al cambiar el umbral del modelo. El eje vertical representa la tasa de verdaderos positivos (TPR), también llamada recall o sensibilidad: TP/(TP+FN). El horizontal muestra la tasa de falsos positivos (FPR): FP/(FP+TN). Al bajar el umbral, detectás más fraudes, pero también generás más falsas alertas. La mejor zona está cerca de la esquina superior izquierda.
El AUC-ROC es la probabilidad de que un fraude elegido al azar reciba un puntaje mayor que una operación legítima elegida al azar, contando 0,5 por empate. Un valor de 1,00 indica un ordenamiento perfecto; 0,50 equivale al azar.
Un AUC de 0,90 . Mide el orden de los puntajes, no el resultado con un umbral concreto. Por eso, ordenar mejor los fraudes no garantiza que las alertas sean útiles en producción.
Más allá del área total, importa cómo rinde el modelo dentro del rango de error que podés aceptar. La proporción de fraudes no afecta directamente a la TPR ni a la FPR. Si solo cambia esa proporción y las distribuciones de puntajes de cada clase se mantienen, la curva ROC puede seguir igual. La precisión, en cambio, sí puede variar.
Compará el recall en la FPR máxima tolerable e informá cuántas alertas y falsos positivos genera el modelo, teniendo en cuenta la capacidad de revisión del equipo.
No te quedes solo con el área total: un modelo con menor AUC puede rendir mejor en el tramo que vas a usar en producción. Cuando hay pocos fraudes, completá esa evaluación con AUC-PR.
Mientras ROC mide la separación global, PR muestra qué tan útiles son las alertas cuando el fraude es poco frecuente.
La curva Precision-Recall (PR) ubica el recall en el eje horizontal y la precisión en el vertical. Cada punto corresponde a un umbral distinto y muestra cuántos fraudes detectás y qué tan confiables son las alertas. Cuando hay pocos positivos, permite ver si detectar más fraudes genera demasiadas falsas alertas.
El AUC-PR resume el equilibrio entre precisión y recall a lo largo de los umbrales; no mide la probabilidad de que un fraude quede por encima de un caso negativo en el ranking. A diferencia de ROC, PR muestra si podés aumentar el recall sin que la precisión caiga demasiado rápido.
Average Precision (AP) no es lo mismo que el área trapezoidal. AP pondera cada incremento de recall por la precisión alcanzada. Si usás average_precision_score de scikit-learn, aclará este criterio: no lo presentes como área trapezoidal.
En un ranking aleatorio, la precisión de referencia se aproxima a la proporción de fraudes. Por eso, junto con AP, informá esa proporción y la cantidad de fraudes confirmados. Compará los modelos en el mismo conjunto de prueba y mantené la distribución real: balancearla artificialmente cambia la precisión esperable en producción.
Buscá mayor precisión al recall que necesitás, no solo un AP global más alto. Usá AP para comparar modelos y después elegí el umbral según la capacidad de revisión y el costo de cada falso positivo.
Cuando el fraude es poco frecuente, ROC y PR muestran cosas distintas: ROC evalúa cómo el modelo ordena los casos; PR muestra qué tan útiles son las alertas cuando hay pocos positivos.
La estabilidad de ROC ante cambios en la prevalencia no basta para evaluar un modelo en producción. La calidad de las alertas puede empeorar aunque el ordenamiento siga igual. Y si cambian los patrones de ataque o los segmentos, ambas métricas pueden variar.
Además, una FPR baja puede traducirse en muchas falsas alertas cuando predominan las operaciones legítimas. Cada métrica ayuda a evaluar un aspecto distinto:
| Aspecto | AUC-ROC: ventaja y límite | AUC-PR: ventaja y límite |
|---|---|---|
| Prevalencia de fraude | Su estabilidad no garantiza que la precisión se mantenga. | Hay que tener cuidado al comparar poblaciones con distinta prevalencia. |
| Falsos positivos | Una FPR pequeña puede ocultar muchas falsas alertas. | La precisión indica qué proporción de las alertas corresponde a fraude. |
| Rango operativo | El área global puede ocultar un mal desempeño en el tramo útil. | La curva permite revisar la precisión en ese tramo, pero el área puede ocultar caídas. |
| Revisión manual | No mide la carga de trabajo. | La calidad de las alertas no indica cuántas habrá que revisar. |
Para evaluar el impacto real, mirá ambas curvas junto con la matriz de confusión y el volumen de alertas del umbral que usarías. El siguiente paso es leerlas en el tramo de umbrales que vas a usar.
Cuando el fraude es poco frecuente, no alcanza con comparar el área bajo la curva: mirá primero la zona en la que vas a trabajar. Evaluá ambos modelos con las mismas transacciones, fechas y reglas de procesamiento, y con una prevalencia representativa de producción. Elegí el modelo y el umbral con el conjunto de validación; reservá el de prueba, sin tocarlo, para el informe final. En fraude, respetá el orden temporal: entrená con datos del pasado, validá con un período posterior y probá con el más reciente.
En ROC, buscá la curva con mayor TPR dentro del FPR que tolerás. En PR, compará precisión a igual recall, o recall a igual precisión. Marcá los umbrales candidatos: un mismo puntaje numérico no representa necesariamente el mismo punto de funcionamiento en ambos modelos. La elección depende de qué error estás dispuesto a tolerar: falsas alertas o fraude sin detectar.
Si las curvas se cruzan, no decidas solo por AUC. Fijá límites de FPR, precisión o volumen diario y compará puntos equivalentes dentro de la región que vas a usar.
| Patrón observado | Decisión |
|---|---|
| Curva ROC con mayor TPR dentro del FPR aceptable | Preferila para detectar más fraude con la misma FPR. |
| PR con mayor precisión al recall objetivo | Preferila para reducir falsas alertas sin perder cobertura. |
| PR con mayor recall a igual precisión | Preferila para detectar más fraude sin aumentar la proporción de alertas incorrectas. |
| Curvas que se cruzan | Elegí según la región en la que vas a trabajar. |
| AUC mayor, pero caída cerca del umbral de producción | Revisá ese tramo antes de elegir. |
| Precisión alta solo con recall muy bajo | Verificá si tolerás dejar gran parte del fraude sin detectar. |
Revisá también los resultados por mes, canal y tipo de cliente: el promedio puede ocultar un deterioro en un grupo o período.
Acompañá las curvas con el período evaluado, el volumen, la cantidad de fraudes confirmados y la prevalencia. Informá intervalos de confianza para las áreas y para las métricas del umbral elegido. Si usás bootstrap y hay dependencia entre los datos, remuestreá por cliente o por bloques temporales, no por transacciones aisladas. Si la diferencia entre modelos es chica, reportá también el intervalo de confianza de esa diferencia, calculado sobre las mismas muestras.
Umbrales de fraude: detección frente a revisiones
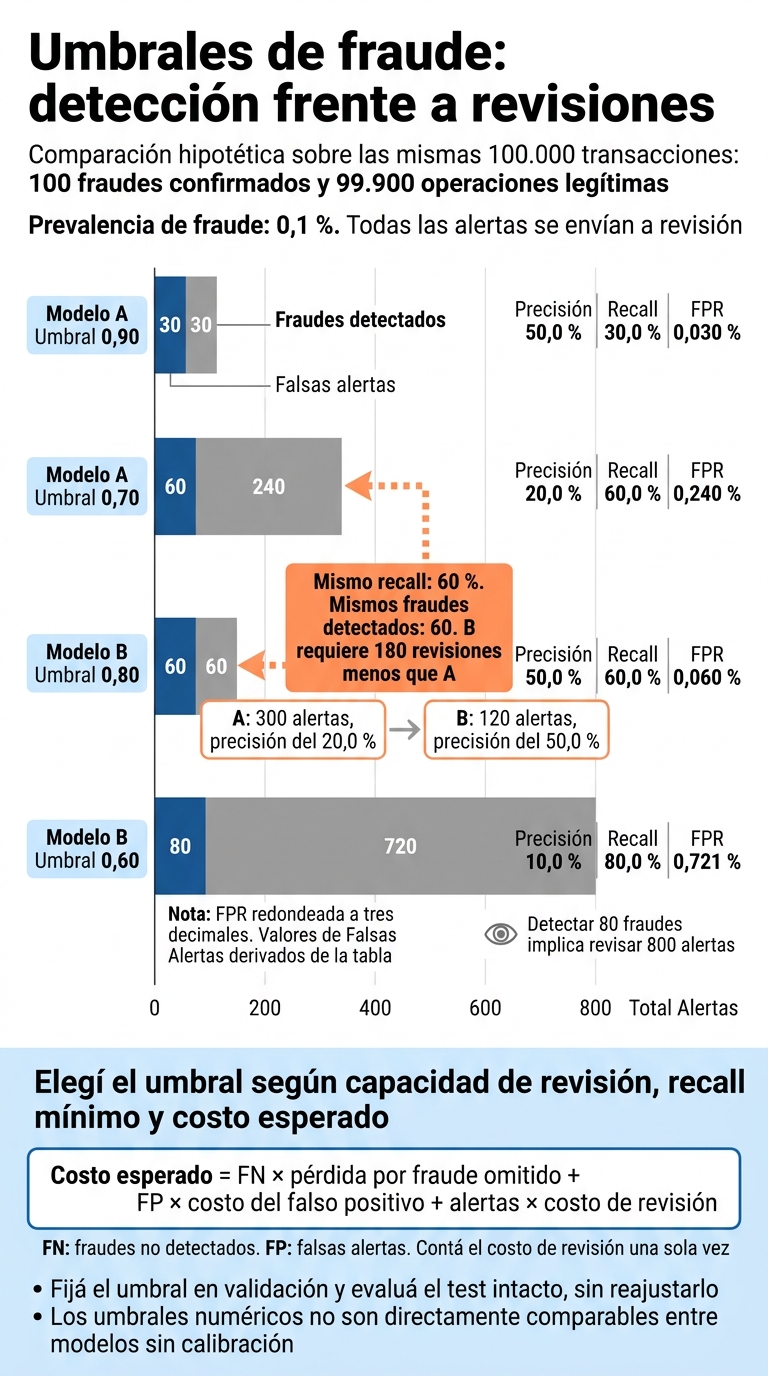
Después de comparar las curvas, definí el umbral que vas a usar en producción. AUC-ROC y AUC-PR resumen el desempeño, pero no indican qué umbral elegir. Para eso, evaluá qué operaciones aprobar, enviar a revisión o bloquear. Bajar el umbral suele generar más alertas y aumentar el recall, aunque la precisión puede fluctuar. No compares umbrales entre modelos sin calibración.
Comparación hipotética: todas las filas usan las mismas 100.000 transacciones, con 100 fraudes confirmados y 99.900 operaciones legítimas. Las alertas se envían a revisión; la FPR está redondeada a tres decimales.
Modelo Umbral Precisión Recall FPR Alertas Fraudes detectados A 0,90 50,0 % 30,0 % 0,030 % 60 30 A 0,70 20,0 % 60,0 % 0,240 % 300 60 B 0,80 50,0 % 60,0 % 0,060 % 120 60 B 0,60 10,0 % 80,0 % 0,721 % 800 80
Si dos umbrales detectan la misma cantidad de fraudes, elegí el que exija menos revisiones y tenga menor costo esperado.
Con el mismo recall del 60 %, B requiere 180 revisiones menos que A.
Definí el umbral en validación según la capacidad del equipo. Revisá también los picos diarios: el promedio no alcanza. Si podés revisar 300 casos por día, medí el recall sobre esas 300 revisiones.
Costo esperado = FN × pérdida por fraude omitido + FP × costo del falso positivo + alertas × costo de revisión.
Contá el costo de revisión una sola vez. Incluí contracargos, mercadería, margen perdido y fricción del cliente según corresponda. Buscá el menor costo que respete la capacidad del equipo y el recall mínimo. Usá umbrales separados para revisión y bloqueo.
Exigí etiquetas maduras: una operación reciente todavía puede recibir un contracargo. Conservá la prevalencia real de fraude - 0,1 % en el ejemplo - y no balances la evaluación. Respetá la separación temporal y usá solo los datos disponibles al momento de decidir.
Fijá el umbral en validación y evaluá el test intacto, sin reajustarlo. Reportá la matriz de confusión, precisión, recall, FPR, alertas, recall a capacidad y costo esperado.
La exactitud no alcanza para elegir: aprobar todo daría 99,9 % de aciertos y cero fraudes detectados. F1 sirve solo si priorizás ese balance entre precisión y recall; de lo contrario, usá costo esperado y capacidad.
Con el umbral fijado, monitoreá el desempeño y la deriva en producción. Cualquier ajuste requiere una nueva validación.
Si el fraude es poco frecuente, usá AP/PR-AUC como métrica principal y AUC-ROC como complemento. Para aplicar esta elección, separá tres niveles de decisión:
| Uso | Métrica recomendada | Qué mide |
|---|---|---|
| Métrica principal | AP o PR-AUC | Equilibrio entre precisión y recall. |
| Complemento de ranking | AUC-ROC | Capacidad de ordenar fraudes por encima de operaciones legítimas. |
| Criterio operativo | Precisión y recall en el top-k, FPR, alertas y costo esperado | Desempeño dentro de la capacidad de revisión. |
Un modelo con menor AP puede ser preferible si funciona mejor en el tramo operativo, según la capacidad de revisión y los costos. Elegí el umbral según la precisión, el recall y el costo, no solo por la métrica global.
Al comparar modelos, usá la misma población, período, reglas y etiquetas. Informá también el volumen y la prevalencia del fraude.
Aclará si reportás AP o el área trapezoidal bajo la curva PR, e indicá el método de cálculo.
No hay una cantidad mínima predefinida de fraudes confirmados. Podés empezar con un enfoque híbrido: entrená un modelo de detección de anomalías, como un autoencoder, usando solo transacciones legítimas para identificar comportamientos fuera de lo habitual.
A medida que tu equipo revise y confirme casos sospechosos, podés sumar esos datos etiquetados para mejorar la detección y obtener estimaciones de AUC más estables con el tiempo.
Para comparar el AUC-PR, mantené en el conjunto de prueba la misma proporción de fraude que enfrenta el sistema en producción.
El AUC-PR resume el desempeño en distintos umbrales y se centra en la clase minoritaria. Pero no te quedes solo con ese número: evaluá también la precisión entre las operaciones de mayor riesgo y el impacto económico. Un AUC-PR más alto no siempre se traduce en menores costos operativos ni en menos falsos rechazos.
Calibrar los puntajes no mejora el AUC, que resume la capacidad del modelo para distinguir casos a través de todos los umbrales. Lo que sí hace la calibración es ajustar el puntaje para que refleje una probabilidad real y te permita elegir umbrales según su impacto económico.
Al ajustar el umbral, podés optimizar decisiones como aprobar, verificar o rechazar, según los costos del fraude y de los falsos rechazos. Todo esto, sin reentrenar el modelo.