Para reducir el fraude sin perder compras legítimas, combino reglas, modelos y revisión humana. Mi punto de partida: definir cuánto cuesta cada decisión y probar en modo observación antes de automatizar.
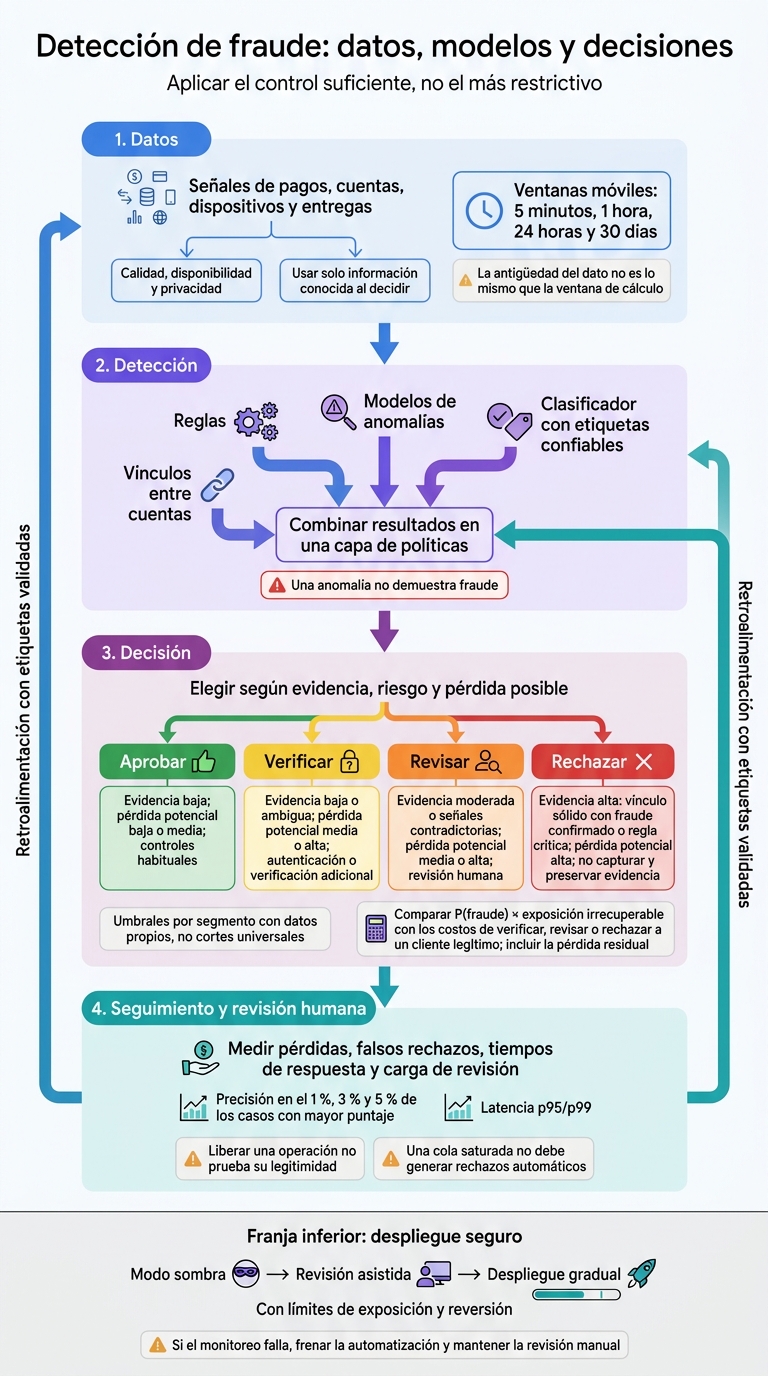
Una compra fuera de lo habitual no alcanza para rechazarla. Por eso, organizo el sistema en cuatro pasos:
Mi criterio es simple: <u>aplicar el control suficiente, no el más restrictivo</u>. Con esa base, puedo ajustar el sistema cuando cambian las compras, las promociones o las formas de fraude.
Detección de fraude: datos, modelos y decisiones
Para pasar de señales a decisiones, definí qué datos tenés, cuándo llegan y con qué calidad. Uní pedidos, intentos de pago, clientes, sesiones, autenticaciones, entregas, promociones, devoluciones, contracargos y resultados de revisión humana mediante identificadores estables.
Guardá una fila por evento o intento de compra. Incluí la hora del evento, la de recepción y la de confirmación del pago, e indicá si el pedido se despachó antes de esa confirmación. En el checkout, registrá importe, moneda, productos, descuentos, envío, método de pago, token del proveedor, cuotas, importe por cuota y descuento o recargo.
Separá autorización, captura y acreditación: una transferencia iniciada no equivale a fondos acreditados. Usá formatos locales consistentes para moneda, fecha, hora y distancia, sin confundir esos formatos con umbrales. Así, cada anomalía funciona como una señal para actuar, no como un veredicto.
| Anomalía |
|---|
| Dato clave |
|---|
| Acción |
|---|
| Importe inusual | Importe y percentiles del cliente y sus pares | Pedir autenticación más fuerte o retener para revisión; no bloquear solo por importe |
| Alta velocidad | Intentos, importes e identificadores por ventana | Limitar reintentos y verificar |
| Diferencia geográfica | IP aproximada, facturación y entrega | Corroborar antes del despacho |
| Dispositivo o sesión inusual | Token de dispositivo, sesión y accesos | Reforzar autenticación |
| Cambios de identidad | Email, teléfono, contraseña y antigüedad | Validar cambios y contacto |
| Pagos anómalos | Tokens, rechazos, motivos y reintentos | Aplicar límites y verificación; distinguir errores y falta de fondos |
| Relaciones inusuales | Cuentas por dirección, dispositivo o token | Revisar conexiones y evidencia adicional |
| Promociones o reintegros atípicos | Cupones, devoluciones, entregas y destino del reintegro | Revisar elegibilidad y destino |
Estas coincidencias requieren más evidencia; no justifican un bloqueo automático. Para las entregas, normalizá domicilio, código postal, localidad y provincia. Registrá también destinatario, retiro o envío, operador logístico, intentos de entrega y cambios posteriores a la confirmación.
Calculá conteos, sumas, identificadores distintos y proporciones de rechazo en ventanas móviles de 5 minutos, 1 hora, 24 horas y 30 días. Hacelo por cliente, dispositivo, dirección e instrumento tokenizado.
Incluí valor del carrito, descuentos, cuotas, antigüedad de la cuenta, cambios de autenticación, pagos fallidos, direcciones reutilizadas y cuentas conectadas. Calculá la proporción de rechazo dividiendo los intentos rechazados por los intentos totales. Si no hay intentos, devolvé “desconocido”.
Compará estos datos con el historial del cliente y con pares de la misma categoría, región, canal y antigüedad. Ajustá los importes según precios actuales o distribuciones recientes, y separá promociones, Hot Sale, CyberMonday y otros períodos estacionales. Si el cliente no tiene historial, usá referencias del grupo y dejá explícita la incertidumbre.
| Tipo | Disponibilidad | Antigüedad del dato | Uso en decisiones |
|---|---|---|---|
| Tiempo real | Durante el checkout o al recibir el evento | Segundos | Velocidad de intentos, autenticación y clasificación inicial |
| Casi tiempo real | Streaming o microprocesamientos frecuentes | Minutos a aproximadamente 1 hora | Relaciones recientes, cambios de entrega y prioridad de revisión |
| Batch | Procesamiento programado | Horas o días, según actualización | Reputación, referencias de comparación y enriquecimiento de redes |
Creá un diccionario de variables que detalle nombre, definición, fuente, ventana, frecuencia de actualización, momento de disponibilidad y unidades. Sumá el tratamiento de faltantes, la clasificación de privacidad, el uso permitido y el responsable.
La antigüedad del dato no es lo mismo que la ventana de cálculo: una variable actualizada ahora puede resumir 30 días. Controlá duplicados, monedas, importes inconsistentes, desfases horarios y respuestas faltantes del proveedor. Diferenciá “no aplica”, “no recopilado” y “falla del sistema”, y documentá qué decisión tomás en cada caso.
Usá uniones con corte temporal: cada decisión debe poder reconstruirse solo con la información conocida en ese momento. Guardá por separado los resultados posteriores, como contracargos, entregas y revisiones, para evitar fuga de información durante el entrenamiento. Conciliá las confirmaciones demoradas sin agregarlas retroactivamente al checkout original.
La calidad del dato también depende de cómo lo guardás y de quién puede acceder. Usá tokens del proveedor, no datos crudos de tarjetas. No guardes CVV después de autorizar, ni siquiera cifrado. Limitá los accesos y los plazos de retención; la Ley 25.326 exige datos adecuados, pertinentes y no excesivos para la finalidad declarada.
Con las variables definidas, transformá las señales en puntajes y decisiones. Las variables de transacción, velocidad y grafo sirven como entrada para reglas, detectores de anomalías y clasificadores.
Separá detección, decisión y ejecución. Empezá por los controles de calidad y las reglas. Después incorporá detectores de anomalías y, cuando tengas etiquetas confiables, un clasificador. Una capa de políticas debe combinar los resultados sin depender de un solo modelo. Antes de sumar complejidad, compará cada incorporación con las reglas y una línea de base simple.
| Método | Fortalezas | Límites | Datos necesarios | Latencia orientativa | Uso en decisiones |
|---|---|---|---|---|---|
| Reglas determinísticas | Transparentes y auditables | Se vuelven rígidas u obsoletas | Eventos y condiciones conocidas | Muy baja | Activar controles; bloquear solo con evidencia fuerte |
| Líneas de base estadísticas | Simples e interpretables | Sensibles a la estacionalidad | Historial por segmento | Baja | Medir desvíos |
| Isolation Forest | Detecta combinaciones inusuales sin etiquetas | El puntaje no es probabilístico; depende de las variables | Muestra representativa | Baja a media | Detectar novedades y priorizar alertas |
| Local Outlier Factor (LOF) | Detecta anomalías respecto de vecinos | Costoso a escala; la inferencia depende de la implementación | Variables numéricas y vecinos representativos | Media | Detectar rarezas dentro de grupos |
| Clustering | Identifica grupos de comportamiento | Un grupo raro no prueba fraude | Variables normalizadas | Media | Generar señales de distancia o pertenencia |
| Autoencoders | Detectan relaciones no lineales | Requieren más ajuste y ofrecen menor explicabilidad | Historial amplio y estable | Media a alta | Detectar anomalías complejas |
| Regresión logística | Rápida e interpretable | Puede perder relaciones no lineales | Etiquetas confiables | Baja | Modelo supervisado base |
| Árboles con gradient boosting | Detectan interacciones en datos tabulares | Riesgo de sobreajuste y fuga de información | Etiquetas y variables históricas | Baja a media | Estimar y ordenar riesgo |
| Features de grafos | Revelan vínculos entre entidades | Requieren resolver identidades; no son un modelo por sí mismas | Relaciones disponibles al decidir | Baja a media | Alimentar modelos o políticas |
La latencia depende del volumen, la implementación y las consultas necesarias; medila en tu entorno.
Ajustá la imputación, la codificación y el escalado solo con los datos de entrenamiento. Usá log(1+x) para variables no negativas con colas largas y estandarizá las variables cuando apliques métodos de distancia o densidad.
Para calcular un desvío robusto, usá z = 0,6745 × (valor − mediana) / MAD. MAD es la mediana de las desviaciones absolutas respecto de la mediana. Si es cero, aplicá una escala mínima de negocio documentada y registrá el reemplazo. También documentá la dirección de cada puntaje: en Isolation Forest, un valor menor indica mayor anormalidad. Calibrá el puntaje antes de usarlo para decidir.[27]
Definí qué acción toma el sistema y en qué orden: puntaje → umbral → revisión / aprobación / rechazo.
La política debe combinar reglas, anomalías, probabilidad calibrada, riesgo de vínculos y exposición irrecuperable. Usá umbrales ordenados y validados, no cortes universales.
Compará P(fraude) × exposición irrecuperable con el costo de verificar, revisar o rechazar a un cliente legítimo. Incluí también la pérdida residual después de cada intervención.
Guardá códigos de motivo, como DISPOSITIVO_NUEVO y ANOMALIA_VALOR_SEGMENTO, junto con las versiones del modelo y de la política. Si la cola supera la capacidad de revisión, aplicá una contingencia definida: no conviertas automáticamente los casos pendientes en rechazos.
Una vez fijada la política, validala con datos históricos y costos reales.
Armá los casos positivos con investigaciones confirmadas, contracargos por fraude y reportes corroborados. Para los negativos, usá operaciones legítimas maduras. Conservá las categorías “pendiente” y “desconocido”: las disputas sin resolver, los pedidos sin etiqueta y las revisiones aisladas no son verdad confirmada.
Usá un corte cronológico y etiquetas cerradas. Revisá las fugas de información por entidades vinculadas y el sesgo por rechazos previos. Tratá el desbalance durante el entrenamiento, pero evaluá con una distribución representativa. Ajustá el calibrador con datos separados de los usados para entrenar el clasificador, nunca con la prueba final.
No habilites decisiones automáticas sin superar los controles de datos, etiquetas, modelo, explicabilidad y operación. Exigí calidad y disponibilidad verificadas, etiquetas documentadas, mejora frente a la línea de base, códigos de motivo y capacidad real de revisión.
Medí por segmento la precisión, el recall, el área bajo precision-recall, los falsos positivos, la pérdida detectada, la tasa de aprobación, la calibración y la latencia de punta a punta. Evaluá también la precisión en el 1 %, 3 % y 5 % superior de la cola y la cantidad diaria de casos.
Probá primero en modo sombra, sin cambiar la experiencia. Después pasá a revisión asistida y a un despliegue gradual, con límites de exposición y reversión. Para pasar a producción, definí tiempos de respuesta, apelación y contingencia, además del monitoreo de deriva y errores.
Cerrá el circuito operativo: evento → validación → variables históricas → reglas y puntajes → política → acción → registro → revisión → feedback. Una vez definida la política, vinculá cada puntaje con una acción, su comunicación y una revisión.
Usá un identificador de correlación para conectar pago, pedido, despacho y reembolso. Dejá claras las responsabilidades: ingeniería se ocupa de los datos y la disponibilidad; riesgo, de las políticas y las etiquetas; soporte, de la comunicación y los reclamos; eCommerce y operaciones, de las retenciones, los horarios de despacho y las excepciones comerciales.
La revisión humana entra en juego cuando el puntaje no alcanza para decidir. Ordená los casos por pérdida esperada, incertidumbre y tiempo hasta el despacho, según la capacidad disponible.
Para evaluar cada caso, el analista necesita el historial de compras, los intentos previos, los dispositivos, las cuentas vinculadas y la evidencia a favor y en contra. También debe saber cuándo estuvo disponible cada dato. Definí plazos según el riesgo, la categoría y el tiempo hasta el despacho. Escalá los vencimientos a riesgo y operaciones.
Registrá, como mínimo, prioridad, exposición, motivo, acción, resultado y fecha de retroalimentación. Cada anulación manual debe incluir la identidad del revisor, la evidencia, el motivo y la hora.
Separá la acción inmediata del resultado confirmado: liberar una operación no prueba su legitimidad. Después, conciliá el caso con investigaciones, contracargos y reembolsos, y conservá ambas fechas. Ajustá el sistema solo con etiquetas validadas. Revisá también las discrepancias entre analistas y los reclamos de clientes legítimos.
Probá la consistencia entre entrenamiento y producción, el presupuesto de latencia de cada etapa, la disponibilidad, la capacidad, los duplicados y la precedencia de reglas. Un reintento no debe duplicar retenciones, mensajes ni reembolsos. Durante el despliegue gradual, ensayá la reversión.
Ante una caída, habilitá el uso exclusivo de reglas solo en segmentos autorizados y con límites de exposición. Derivá el resto de los casos según su riesgo. Registrá la versión del modelo, la política aplicada, las reglas activadas y la decisión final.
Monitoreá la latencia p95/p99, los datos faltantes, la deriva, la antigüedad de la cola y los tiempos de espera. Sumá las pérdidas confirmadas cuando maduren las etiquetas. Exigí cifrado, permisos por rol, auditoría y retención limitada.
Si el monitoreo falla, frená la automatización y mantené la revisión manual.
En canales comerciales integrados, el contexto conversacional también puede alimentar una capa de riesgo separada. Burbuxa puede aportar conversaciones y contexto comercial como señal secundaria, tras verificar las APIs, los permisos y la actualización de los datos. Usalo solo como contexto comercial adicional, no como motor antifraude ni como reemplazo de los controles de pago.
Con la cadena señal → evidencia → acción definida, probá en modo sombra y medí los falsos positivos, el volumen de revisión y la latencia. Después, activá una sola acción de bajo riesgo en un segmento y ampliá el despliegue por etapas.
La exactitud global no alcanza: optimizá teniendo en cuenta la pérdida por fraude, el margen perdido por falsos rechazos, el costo de revisión, la fricción y la latencia.
Elegí la acción según la evidencia de fraude y la pérdida potencial. Un importe alto aumenta la pérdida posible, pero no demuestra fraude.
| Evidencia de fraude | Pérdida potencial | Control siguiente | Acción |
|---|---|---|---|
| Baja | Baja o media | Controles habituales | Aprobar |
| Baja o ambigua | Media o alta | Autenticación o verificación adicional | Verificar |
| Moderada; señales contradictorias | Media o alta | Revisión humana | Revisar |
| Alta; vínculo sólido con fraude confirmado o regla crítica | Alta | No capturar; preservar evidencia | Rechazar |
Definí umbrales por segmento con datos propios, no con bandas universales. Usá la matriz para aplicar la acción mínima suficiente y revisala cuando cambien el fraude, los precios, las promociones, el comportamiento de pago o la capacidad operativa.
Empezá con un enfoque híbrido: entrená un autoencoder solo con transacciones normales para detectar anomalías sin depender de etiquetas previas. Después, sumá una revisión humana de los casos sospechosos. Esa revisión te permite etiquetar datos reales y usarlos para entrenar modelos más precisos con el tiempo.
Usá umbrales conservadores y ajustalos de a poco según las métricas de las muestras revisadas. Monitoreá los datos de forma continua para reducir los falsos positivos.
Combiná desvíos respecto de lo habitual - tiempos, montos promedio y horarios - con patrones históricos de fraude. Si una conducta indica alto riesgo, pero coincide con cambios esperables por la temporada o la operación, como Hot Sale, CyberMonday o tickets más altos, usá umbrales dinámicos en lugar de fijos.
Para no sobrestimar los resultados con una validación aleatoria, validá con cortes temporales o ventanas móviles. Antes de escalar, probá primero en modo sombra y después en canario.
Compará el antes y el después con referencias que se puedan auditar: falsos positivos (órdenes legítimas bloqueadas), recall de fraude, conversión y cantidad de órdenes enviadas a revisión manual.
Probá primero en modo sombra y después hacé una prueba A/B con el 10 % del tráfico durante al menos dos semanas, fuera de fechas pico. Si suben los rechazos o las alertas sin reducir el fraude ni los contracargos, la verificación está sumando fricción y haciendo perder ventas.