Antes de enviar más mensajes, defino cuánto tráfico puedo manejar y cuándo tengo que frenarlo. Mi punto de partida: reducir tareas de baja prioridad al 80 % de uso y pausar campañas de marketing en WhatsApp al 90 %, siempre que pueda medir la cuota.
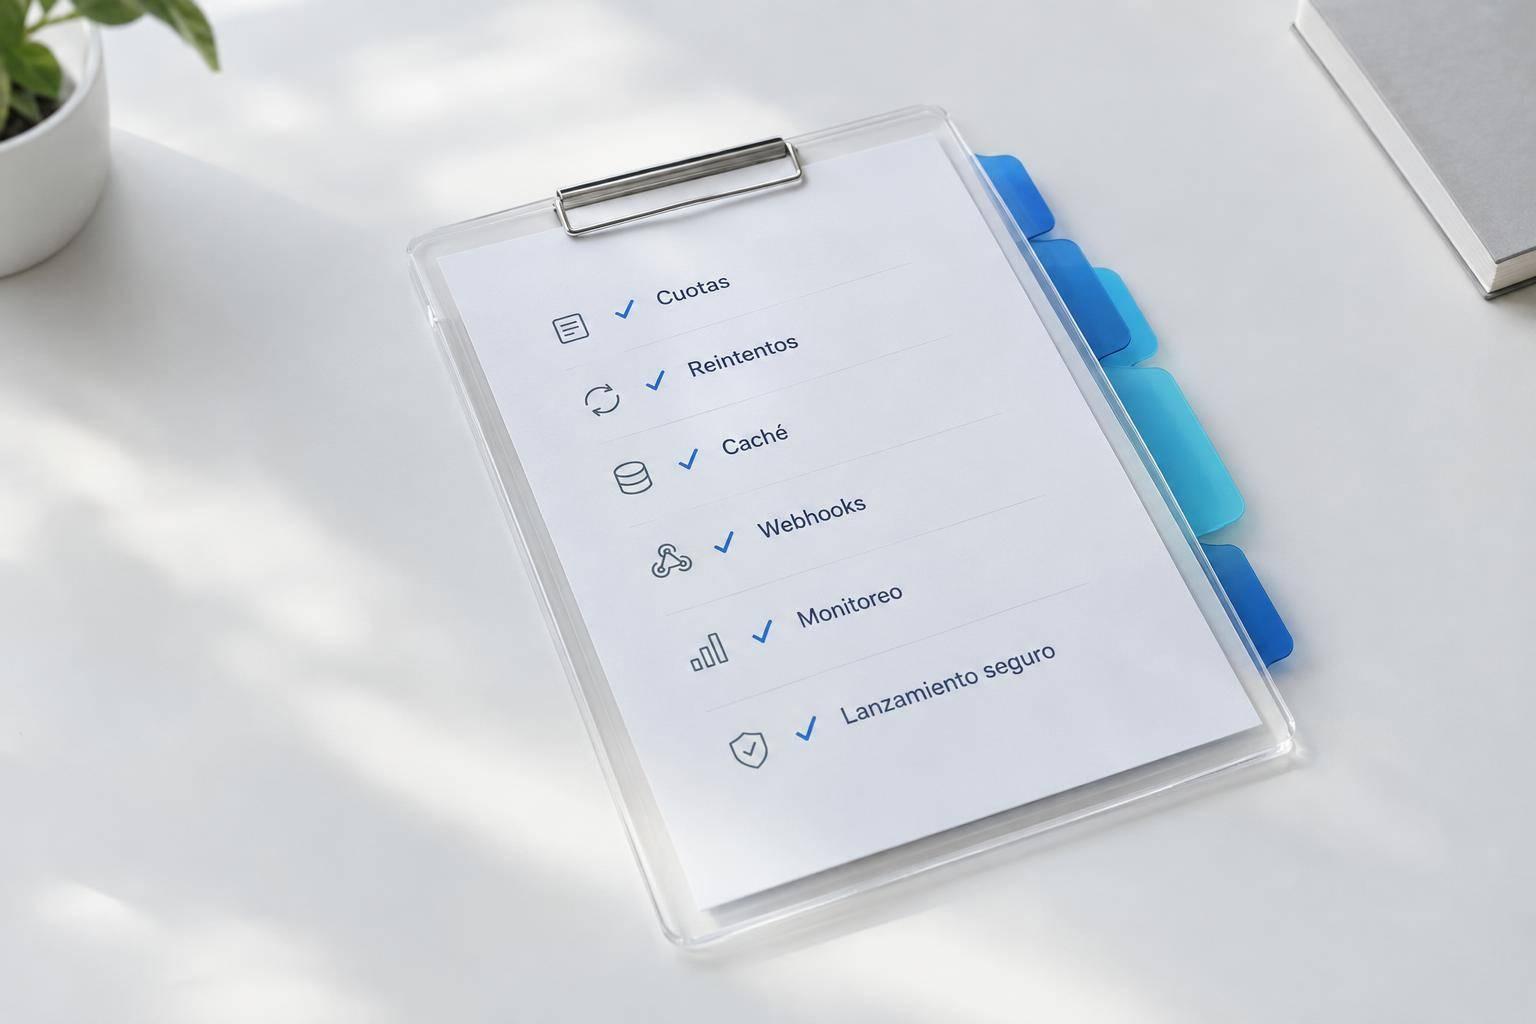
Para lanzar WhatsApp, Instagram y Graph API, reviso seis puntos:
Mi regla es simple: <u>si no puedo confirmar el resultado de una acción, no la repito a ciegas</u>. Primero verifico qué pasó; después decido si corresponde reintentar. Y paso a producción de a poco, sin pendientes críticos.
Rate limits de Meta API: cuándo frenar y cómo reintentar
Registrá X-App-Usage, X-Page-Usage, X-Business-Use-Case-Usage y Retry-After junto con el endpoint, el ámbito, la fecha y hora, el código HTTP, el código de error de Meta y el ID de solicitud. Interpretalos según el endpoint: no son contadores equivalentes.
Leé cada señal según su ventana. El porcentaje de uso no indica cuántas solicitudes quedan ni supone un reinicio común. Si falta un header, marcá la cuota como «sin visibilidad de cuota», mantené límites internos conservadores y consultá la documentación. Esa ausencia no es motivo para aumentar el tráfico.
Si recibís Retry-After, pausá el ámbito afectado durante al menos el tiempo indicado y aplicá la pausa a todos los procesos. Después, retomá de a poco: liberar toda la cola de golpe puede causar otro bloqueo.
Usá estas señales para ajustar el ritmo antes de intervenir en la cola.
Con la cuota visible, controlá los envíos de todos los procesos. Usá un token bucket o leaky bucket compartido por ámbito, con estado atómico y que también cuente los reintentos. Los contadores locales no alcanzan cuando varios procesos consumen la misma cuota. Separá el cupo sostenido del cupo de ráfaga y respetá también cualquier cuota superior compartida.
Cuando puedas medir el uso, fijá dos umbrales internos: al 80 %, reducí los trabajos de baja prioridad; al 90 %, pausá las campañas de WhatsApp y las lecturas no esenciales. Reservá capacidad para soporte y mensajes transaccionales. Esto es vital para mantener un servicio al cliente eficiente incluso bajo presión de cuota.
Probá qué pasa ante picos de campaña, la recuperación simultánea de procesos y un aumento brusco de conversaciones entrantes. En cada prueba, exigí una cola acotada, capacidad reservada para soporte y un retorno automático al ritmo sostenido.
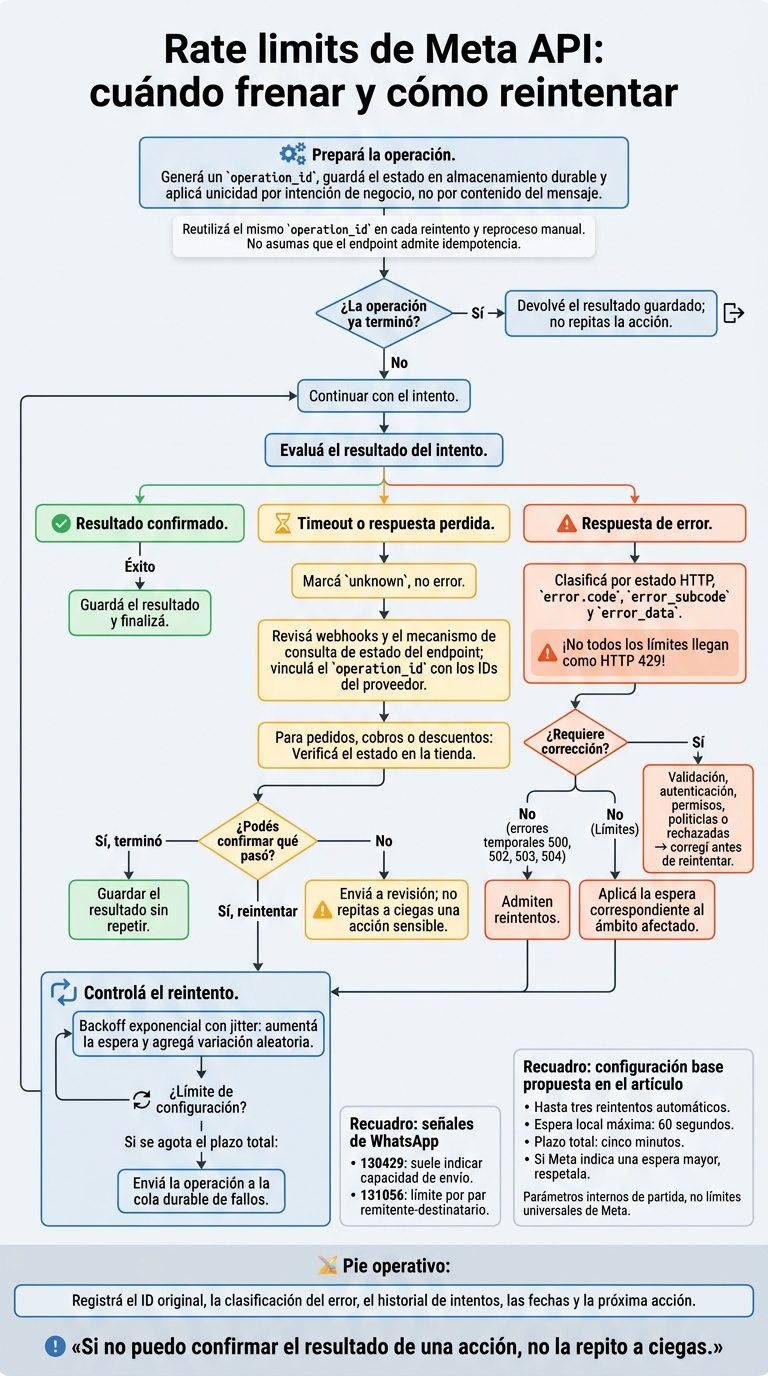
Con los límites ya medidos, definí qué hace el sistema cuando falla un intento o no llega la respuesta. Clasificá cada respuesta por estado HTTP y por error.code, error_subcode y error_data: no todos los límites llegan como HTTP 429. Los errores temporales 500, 502, 503 y 504 pueden admitir reintentos. En WhatsApp, 130429 suele indicar capacidad de envío y 131056, un límite por par remitente-destinatario. Los errores de validación, autenticación, permisos, políticas y plantillas rechazadas necesitan una corrección antes de reintentar.
Configurá backoff exponencial con jitter: aumentá la espera entre intentos y agregá una variación aleatoria para que los procesos no reintenten al mismo tiempo. Como base, permití hasta tres reintentos automáticos, con una espera local máxima de 60 segundos y un plazo total de cinco minutos. Si Meta indica una espera mayor, respetala. Si se agota el plazo total, enviá la operación a la cola durable de fallos.
Generá un operation_id y reutilizalo en cada reintento. No des por hecho que el endpoint admite idempotencia. Guardá el estado de la operación en almacenamiento durable y aplicá unicidad por intención de negocio, no por contenido del mensaje. Si la operación ya terminó, devolvé el resultado guardado.
Si se agota el tiempo de espera o se pierde la respuesta, marcá el resultado como unknown, no como error. Antes de reenviar, revisá los webhooks y el mecanismo de consulta de estado del endpoint. Vinculá el operation_id con los IDs del proveedor para reconciliar el resultado. Para pedidos, cobros o descuentos, verificá el estado en tu automatización para TiendaNube. Si no podés confirmar qué pasó, enviá el caso a revisión en vez de repetir una acción sensible.
Registrá el ID original, la clasificación del error, el historial de intentos, las fechas y la próxima acción. Antes de pasar a producción, probá los límites de aplicación, cuenta comercial, número y destinatario - incluidos 130429 y 131056 - según la versión desplegada. Verificá que cada caso active la espera correcta, termine dentro del plazo y no duplique la acción. En los reprocesos manuales, reutilizá el operation_id. Registrá estos eventos para alimentar las alertas y los logs.
Después de controlar los reintentos, eliminá las lecturas repetidas para consumir menos cuota.
Definí clave de caché, TTL e invalidación por recurso. Podés guardar descripciones e imágenes durante minutos u horas; los datos que cambian con frecuencia necesitan actualizaciones más seguidas. Invalidalos cuando el origen notifique cambios. Antes de confirmar una compra, verificá la disponibilidad y actualizá el total. Guardá la fecha de última sincronización y respondé con el estado en verificación si no tenés datos actualizados.
Eliminá las consultas que repiten datos ya disponibles en webhooks o en el almacenamiento local. Pedí solo los campos necesarios y agrupá lecturas únicamente donde la API lo permita. Menos conexiones o respuestas más chicas no garantizan un menor consumo de cuota: revisá cómo contabiliza las solicitudes cada endpoint.
No vuelvas a consultar por API un dato que ya llegó por webhook.
Usá los eventos disponibles de mensajes, estados de entrega y cambios de cuenta para reducir llamadas. Reservá el sondeo para reconciliación o para los casos sin un webhook equivalente. Confirmá los campos y permisos de cada producto.
En el endpoint HTTPS, validá la firma sobre el cuerpo original y guardá el evento en almacenamiento durable antes de responder HTTP 200. Después, procesá de forma asíncrona las consultas a la tienda y la generación de respuestas.
Guardá el event_id y la regla para aplicar cada evento una sola vez. Documentá cómo tratar los eventos fuera de orden y cómo reprocesarlos desde la cola de fallos. En WhatsApp, vinculá cada estado con su WAMID: no lo deduzcas por el orden de llegada. Un estado atrasado no debe reemplazar uno posterior ni repetir efectos sobre pedidos o inventario.
Al reducir las lecturas, también tenés que preparar el sistema para las ráfagas de eventos y sus reentregas.
Dimensioná el procesamiento de webhooks entrantes por separado del envío de mensajes. Meta recomienda capacidad para hasta tres veces el tráfico saliente en estados de entrega, más los mensajes entrantes previstos.
Probá duplicados, eventos desordenados, caídas de la base de datos, saturación de la cola y recuperación tras varias horas sin servicio. Estas ráfagas pueden disparar consultas y consumir cuota de forma indirecta.
Medí la latencia del acuse, la antigüedad de la cola y el tiempo de recuperación. Limitá el reprocesamiento para no saturar la cola, la base de datos ni los workers. Registrá el plazo de reintento de cada producto: WhatsApp Cloud API puede reintentar entregas fallidas durante hasta siete días, pero no asumas ese mismo plazo para Instagram.
Una vez definidos los reintentos y webhooks, medí qué pasa en producción. Así podés detectar presión sobre las cuotas antes de que se produzca un bloqueo.
Separá los paneles de WhatsApp, Instagram, otras llamadas de Graph API y webhooks. Usá filtros por plataforma, cuenta, aplicación, endpoint, versión y entorno. Medí:
Registrá el alcance y la fuente de cada medición de cuota.
Aceptado no equivale a entregado. Vinculá el ID que devuelve WhatsApp con los estados posteriores: accepted, sent, delivered, read, failed y unknown. Usá unknown solo para resultados sin confirmar, no para fallos. Correlacioná los errores de API y de webhook en el tablero.
Usá esos estados para definir alertas y umbrales internos alineados con los controles de cuota. Configurá avisos por colas que crecen, errores repetidos, trabajos fuera del SLA y demoras de entrega. Cada alerta debe tener responsable, severidad, escalamiento y runbook.
El runbook debe indicar cuándo pausar campañas, reducir la concurrencia, ajustar la demora del reintento, revisar consumidores y eventos en la cola de fallos o investigar entregas. Antes de pasar a producción, comprobá que el aviso llegue y se cierre automáticamente cuando la métrica vuelva a su rango normal.
Además de las alertas, dejá trazabilidad para auditoría, correlación y soporte.
Guardá timestamp UTC, plataforma, alcance, endpoint, versión, método HTTP, estado HTTP, código y subcódigo de Meta, IDs de correlación y traza, metadatos de uso, intento, demora del reintento, duración y resultado final. Para los webhooks, agregá el tipo de evento, la hora de recepción, el acuse y el resultado.
No registres tokens, secretos, encabezados de autorización, contenido de mensajes, URLs de medios ni payloads completos. Ocultá los datos sensibles antes de almacenarlos y aplicá controles de acceso por rol, cifrado, retención, borrado y auditoría. Usá identificadores seudonimizados para correlacionar eventos y enviá los tokens por headers, nunca por la URL. Comprobá estas reglas con pruebas de ocultamiento.
Guardá las fechas en UTC y mostralas en America/Argentina/Buenos_Aires, con formato DD/MM/AAAA y horario de 24 horas. Incluí la zona horaria en las alertas.
Antes de habilitar WhatsApp e Instagram, completá una matriz de validación con control, criterio de aprobación, responsable, evidencia y estado (Aprobado/Fallido/Pendiente). Incluí todos los controles ya validados: cuotas, ventanas, ráfagas, headers, limitadores, colas, reintentos, deduplicación, caché, webhooks, alertas y logs.
Para cada pendiente, indicá el impacto, la fecha límite y la condición de cierre. No habilites producción con pendientes críticos.
Con la matriz cerrada, adjuntá la evidencia de las pruebas de carga sostenida, ráfagas, reintentos, duplicados, recuperación de webhooks y enmascarado de datos. Usá mocks o fallos controlados: no satures endpoints de Meta. Registrá el entorno, la versión, la fecha y hora, la carga, la duración, los resultados esperados y observados, y las métricas.
Prepará runbooks para cuota agotada, caída de Meta, credenciales inválidas, caída de webhooks y restricciones de calidad o de cuenta. Asigná un responsable operativo, un respaldo y una persona autorizada para aprobar la recuperación.
Con los runbooks listos, habilitá el tráfico de a poco. Arrancá con una fracción chica, escalá por segmento y ampliá por grupos. Reservá capacidad para soporte humano y priorizá las respuestas transaccionales sobre las campañas.
Para campañas, soporte y conversaciones de IA con Burbuxa, dejá por escrito qué controla la integración con Burbuxa, qué gestiona tu integración y qué depende de Meta.
Antes de activar el tráfico, fijá los umbrales de cuota, errores y antigüedad de cola que frenan el despliegue. Definí qué se pausa primero, cómo conservar las tareas y cómo revertir la configuración.
Para reanudar, exigí una causa identificada, una prueba satisfactoria con volumen reducido, uso estable, webhooks recuperados y aprobación explícita.
Sin headers de uso, no podés ajustar la tasa de envío según la capacidad restante. Para no superar los límites permitidos, implementá controles de tráfico del lado del cliente, como Token Bucket o Fixed Window.
Configurá alertas para los errores 429: te ayudan a detectar cuándo superás esos límites. Ante fallas transitorias o límites excedidos, usá siempre retroceso exponencial con variación aleatoria (jitter) para evitar saturar la API.
Priorizá el tráfico de tu API: reservá capacidad para las funciones críticas y aplicá límites más estrictos a las campañas de marketing.
Usá Token Bucket o Leaky Bucket para controlar las solicitudes y evitar picos de tráfico. Monitoreá el uso en tiempo real con los encabezados de respuesta, como X-App-Usage, y ajustá el tráfico cuando te acerques a los límites permitidos.
Limitá los reintentos automáticos a entre 3 y 5 intentos en 30 minutos, con backoff exponencial y jitter: aumentá la espera entre intentos y agregá una variación aleatoria. Si la operación sigue fallando, enviá el evento a una cola de mensajes fallidos (DLQ) para revisión manual.
Derivá también a una persona los reembolsos fuera de política, las cancelaciones de pedidos ya despachados, las fallas repetidas en plantillas y los errores persistentes para un mismo usuario.