Arrancaría con métodos ensemble como Random Forest como referencia y elegiría XGBoost solo si mejora el pronóstico a un costo que pueda sostener. Para decidir, compararía ambos con los mismos datos y cortes de tiempo, para horizontes de 7, 14 o 28 días.
Primero revisaría una diferencia: vender cero unidades no significa tener demanda cero. Si hubo falta de stock, las ventas no muestran todo lo que los clientes querían comprar.
En la comparación mediría error, tiempo de entrenamiento, latencia y memoria. También revisaría cuánto ajuste necesita cada modelo y cómo puedo explicar sus predicciones.
Comparación rápida
| Criterio | Random Forest | XGBoost |
|---|---|---|
| Cómo aprende | Promedia árboles entrenados por separado. | Agrega árboles que corrigen errores anteriores. |
| Precisión | Lo usaría como referencia inicial. | Lo elegiría si reduce el error en la prueba temporal. |
| Entrenamiento | Permite entrenar árboles en paralelo. | Combina árboles en secuencia con paralelismo interno. |
| Ajuste y mantenimiento | Suele requerir menos ajuste inicial. | Puede exigir más búsqueda y seguimiento. |
| Datos faltantes | Depende de la biblioteca y su versión. | Los maneja de forma nativa. |
| Latencia y memoria | Las mediría según tamaño y cantidad de árboles. | Las mediría según configuración y datos. |
| Interpretación | Revisaría importancia por permutación y casos puntuales. | Usaría importancias y explicaciones locales como SHAP. |
Mi regla sería <u>comparar antes de elegir</u>: usaría backtesting temporal, mediría MAE, WAPE y sesgo, y separaría los resultados por rotación, promociones y quiebres de stock. Para Argentina, incluiría Hot Sale, CyberMonday y feriados, siempre con información conocida al emitir el pronóstico y copias históricas de los datos.
Random Forest usa el historial de ventas e inventario para pronosticar la demanda y planificar la reposición. Cada árbol se entrena con una muestra distinta del historial, con reemplazo: algunas observaciones se repiten y otras quedan afuera. En cada división, también evalúa un subconjunto aleatorio de variables. Al promediar las predicciones, el bosque suele tener menor varianza que un árbol individual.
Pero el modelo no arregla un historial mal armado ni elimina el sesgo de los datos. Para que esta lógica funcione mejor, las variables deben estar alineadas por SKU y fecha.
Construí una fila por SKU y fecha objetivo, y definí qué querés predecir: por ejemplo, las unidades vendidas durante los próximos 7 días. En Argentina, usá fechas y moneda en formato local e incluí Hot Sale, CyberMonday y los feriados nacionales en el calendario.
Sumá rezagos de ventas de 1, 7, 14 y 28 días, junto con promedios móviles calculados solo con datos previos. Incluí únicamente las promociones conocidas al momento de predecir. Agregá el stock disponible, las horas o días con stock y el estado de la publicación. Estas señales ayudan a distinguir una caída de demanda de una falta de inventario. La validación temporal te permite comprobar si esa base alcanza.
Los árboles se entrenan en paralelo, así que podés repartir el trabajo entre varios núcleos de CPU. Para empezar, probá unos cientos de árboles, una profundidad limitada y un mínimo de observaciones por hoja que evite grupos demasiado pequeños. Ajustá esos parámetros con validación temporal.
Random Forest puede servir en catálogos medianos si hay suficiente historial por SKU. La cantidad de SKU, por sí sola, no define cuánto puede aportar: también importan la rotación y la intermitencia de las ventas.
Los árboles muy profundos pueden aprender ruido y sobreajustar. Agregar más árboles aumenta el consumo de memoria y la latencia, pero no garantiza una mejora proporcional. Medí ambos en el equipo que ejecutará los pronósticos. Si el costo crece sin una mejora clara, limitá la profundidad o aumentá el mínimo de observaciones por hoja.
Revisá la implementación de RandomForestRegressor en scikit-learn: el soporte de valores faltantes cambia según la versión. Si necesitás imputar, ajustá el imputador solo con el período de entrenamiento y agregá indicadores de valores faltantes.
La importancia de variables muestra qué señales pesaron más en el ajuste global; no explica cada pronóstico ni demuestra causalidad. Las variables correlacionadas pueden repartirse esa importancia y dificultar su lectura. Complementá el ranking del bosque con importancia por permutación sobre una validación temporal y explicaciones locales para revisar predicciones puntuales. El siguiente paso es ver cómo XGBoost modela relaciones más complejas.
A diferencia de Random Forest, XGBoost parte de una predicción inicial y agrega árboles en secuencia. Cada árbol corrige el error acumulado según la función objetivo elegida, que también penaliza la complejidad del modelo. Puede aprender relaciones complejas y trabajar con grandes volúmenes de datos. Pero no garantiza más precisión que Random Forest: esa ventaja debe comprobarse con validación temporal.
XGBoost puede combinar precio, descuento, estacionalidad, disponibilidad y atributos del producto. Usá esas variables para modelar cómo interactúan el precio, el descuento y la estacionalidad en cada categoría.
En cada división de los árboles, XGBoost aprende qué rama deben seguir los valores faltantes. Esto define su recorrido, no su significado: un dato faltante no equivale a cero, y un quiebre de stock puede ocultar demanda. Revisá de dónde vienen esos faltantes para no confundir la falta de stock con una caída real de la demanda.
En catálogos medianos y grandes, controlá learning_rate, la profundidad y la regularización. Una tasa menor suele requerir más árboles, pero permite actualizaciones más graduales. Usá early stopping con validación cronológica para detener el ajuste cuando la métrica deje de mejorar durante la cantidad de rondas definida. Guardá best_iteration y best_score para registrar la mejor ronda y su métrica de validación.
El costo depende del hardware, la implementación, el tamaño del historial y la cantidad de configuraciones probadas. Para catálogos grandes, evaluá tree_method="hist" y medí tiempo, memoria y latencia. El paralelismo interno no elimina la secuencia entre árboles.
Usá importancias o SHAP para ver qué señales usa el modelo, sin interpretarlas como causalidad. Para comparar las configuraciones, medí precisión, tiempo y memoria sobre el mismo backtest.
Random Forest vs XGBoost: comparación con backtesting temporal
Compará el error y el consumo de recursos de ambos modelos bajo las mismas condiciones.
| Criterio | Random Forest | XGBoost |
|---|---|---|
| Precisión | Puede servir como referencia inicial. | Puede reducir el error con ajuste. |
| Tiempo de entrenamiento | Entrena árboles en paralelo; el tiempo depende de su tamaño y cantidad. | Depende de la configuración y del costo total de búsqueda de hiperparámetros. |
| Latencia | Medila con el mismo lote y hardware. | Medila con el mismo lote y hardware. |
| Memoria y costo operativo | Crecen con la cantidad y el tamaño de los árboles. | Dependen de la configuración y la representación de los datos. |
| Datos faltantes | El soporte depende de la biblioteca y la versión. | Tiene manejo integrado de faltantes. |
| Hiperparámetros | Puede requerir menos ajuste inicial. | Puede requerir más búsqueda. |
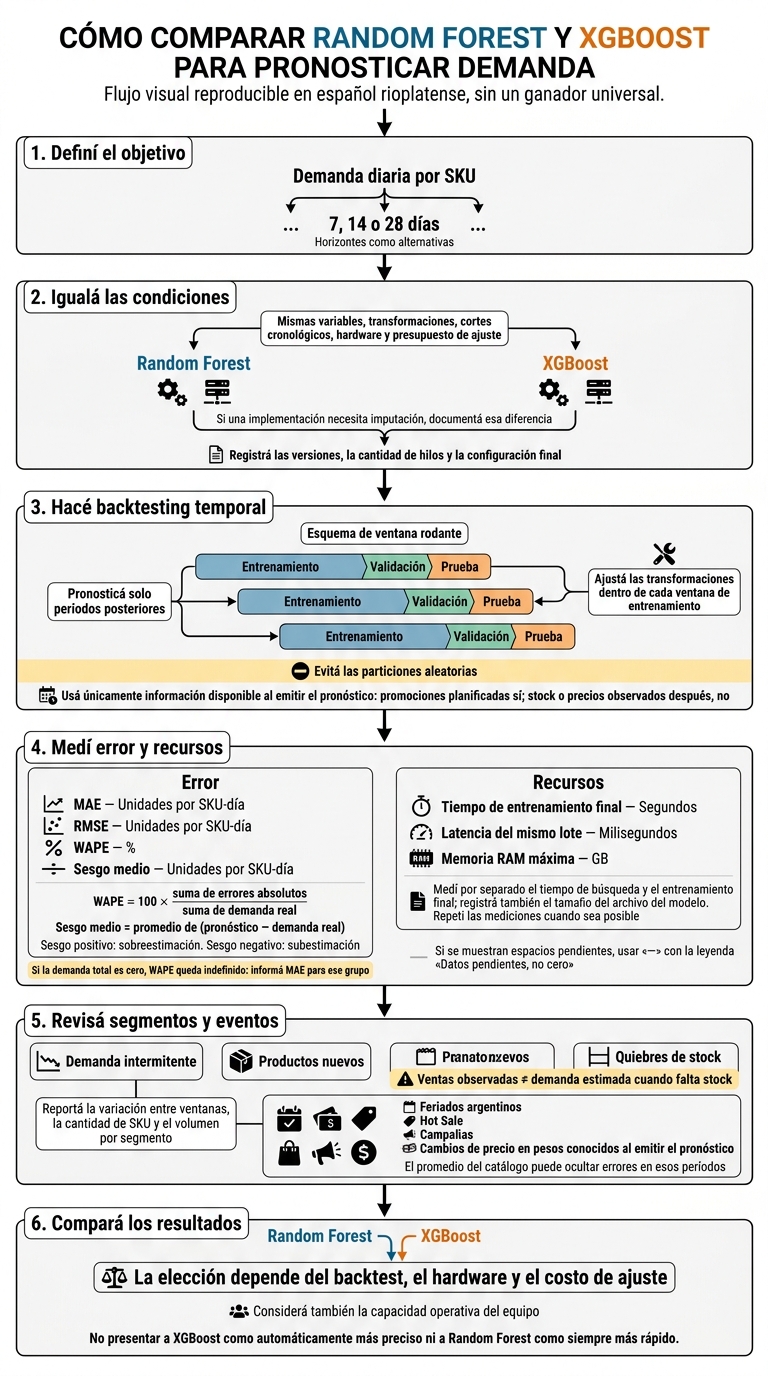
La elección depende del backtest, el hardware y el costo de ajuste. Usá el mismo backtest y presupuesto de ajuste para ambos modelos. Registrá las versiones, la cantidad de hilos y la configuración final.
Medí por separado el tiempo de búsqueda y el de entrenamiento final. También registrá la latencia, la RAM máxima y el tamaño del archivo del modelo. Repetí las mediciones cuando sea posible.
Definí como objetivo la demanda diaria por SKU, con un horizonte de 7, 14 o 28 días. Usá las mismas variables, transformaciones y cortes cronológicos en ambos modelos. Si una implementación necesita imputación, documentá esa diferencia.
Separá entrenamiento, validación y prueba en orden cronológico. En el backtesting de ventana rodante, avanzá el corte y pronosticá solo los períodos posteriores. Ajustá las transformaciones dentro de cada ventana de entrenamiento y evitá las particiones aleatorias.
Usá únicamente información disponible al emitir el pronóstico: podés incluir promociones planificadas, pero no stock ni precios observados después. Medí ambos modelos con las mismas métricas y sobre el mismo período de prueba.
Completá la tabla solo con resultados medidos, con el mismo hardware y presupuesto de ajuste. Los guiones indican datos pendientes, no valores iguales a cero.
Calculá el sesgo como el promedio de la diferencia entre el pronóstico y la demanda real: un valor positivo indica sobreestimación; uno negativo, subestimación.
| Métrica | Unidad | Random Forest | XGBoost |
|---|---|---|---|
| MAE | Unidades por SKU-día | - | - |
| RMSE | Unidades por SKU-día | - | - |
| WAPE | % | - | - |
| Sesgo medio | Unidades por SKU-día | - | - |
| Tiempo de entrenamiento final | Segundos | - | - |
| Latencia del mismo lote | Milisegundos | - | - |
| Memoria RAM máxima | GB | - | - |
Calculá WAPE como 100 × suma de errores absolutos / suma de demanda real. Si la demanda total es cero, WAPE queda indefinido: informá MAE para ese grupo.
Reportá la variación entre ventanas, la cantidad de SKU y el volumen por segmento. Separá la demanda intermitente, los productos nuevos y los quiebres de stock. En estos últimos, distinguí las ventas observadas de la demanda estimada.
Compará también los períodos con feriados argentinos, Hot Sale, campañas y cambios de precio en pesos conocidos al emitir el pronóstico. El promedio del catálogo puede ocultar errores en esos períodos. Al evaluar los resultados del backtest, tené en cuenta también la capacidad operativa del equipo.
Compará MAE, WAPE, latencia y RAM en el mismo backtest. Con esos resultados, elegí según lo que tu equipo pueda ejecutar y mantener. Usá Random Forest como modelo base y probá XGBoost si el backtest muestra interacciones no lineales o mayor complejidad.
Los resultados fuera de muestra deben pesar más en la decisión, sin dejar de lado la infraestructura, el monitoreo y el mantenimiento. Una pequeña reducción del error puede no compensar una operación más cara o frágil.
Tomá estas recomendaciones como puntos de partida, no como garantías.
| Requisito | Recomendación inicial con Random Forest | Recomendación inicial con XGBoost | Cómo validarlo |
|---|---|---|---|
| Tamaño del catálogo | Usarlo como modelo base rápido. | Probarlo si hay señales de relaciones complejas. | Comparar precisión, tiempo, memoria y estabilidad. |
| Calidad de datos | Usarlo con imputación documentada e indicadores de faltantes. | Probar el manejo nativo de faltantes. | Comparar faltantes equivalentes y monitorear cambios de distribución. |
| Capacidad del equipo | Priorizarlo si hay poca capacidad de mantenimiento. | Usarlo si el equipo puede ajustar, monitorear y mantener el modelo. | Registrar configuración, esfuerzo de reentrenamiento y fallos. |
| Interpretación | Usar importancia por permutación y diagnósticos por producto. | Combinar importancia de variables con explicaciones locales. | Verificar estabilidad entre ventanas. |
| Objetivo de precisión | Mantenerlo como referencia. | Priorizarlo si mejora en segmentos clave. | Definir un umbral de error y un rango de confianza. |
Reservá las explicaciones locales para revisar casos puntuales. Antes de elegir, definí cuánto debería bajar el error para justificar el trabajo adicional de mantener el modelo.
Si ya elegiste el modelo, el siguiente paso es preparar los datos que lo alimentan.
Si tu operación está conectada a Burbuxa, sincronizá productos, pedidos, inventario, descuentos y políticas para armar insumos consistentes para el pronóstico. Guardá copias históricas y validá el calendario de promociones: el estado actual no permite reconstruir el pasado.
No hay un mínimo que sirva para todos los casos. Lo que importa es cuántos ciclos comparables cubren tus datos para identificar la estacionalidad y las tendencias. Si el contexto es estable, pocos datos pueden alcanzar. Si hay más complejidad o intervienen variables externas, necesitás series más largas y consistentes.
Para SKU de baja rotación, lo ideal es agrupar por familia de productos. La validación debe seguir un orden estrictamente cronológico para evitar sesgos por el uso de información futura.
Cuando un producto se queda sin stock, las ventas no muestran la demanda real. El Commerce Brain de Burbuxa estima cuánto se habría vendido a partir de la estacionalidad, el clima, los eventos locales, las tendencias en redes sociales, los artículos similares y los atributos del producto.
Marcá los períodos sin stock y registrá tanto las unidades disponibles como el tiempo que faltó el producto. Así evitás distorsiones en los datos. En Argentina, separá las unidades vendidas de los ingresos en ARS para que la inflación no altere la lectura de la demanda.
Revisá el modelo cada trimestre y cada año con datos recientes y métricas como el MAPE. En procesos de alta frecuencia, revisá las métricas mensualmente. Reentrená cuando cambien el mercado, el catálogo, los precios o las compras, o cuando el modelo pierda capacidad predictiva.
Si hay fluctuaciones inesperadas o nuevos productos, necesitás poder reentrenar en horas. Validá con backtests móviles y evitá las particiones aleatorias que incorporen información futura.